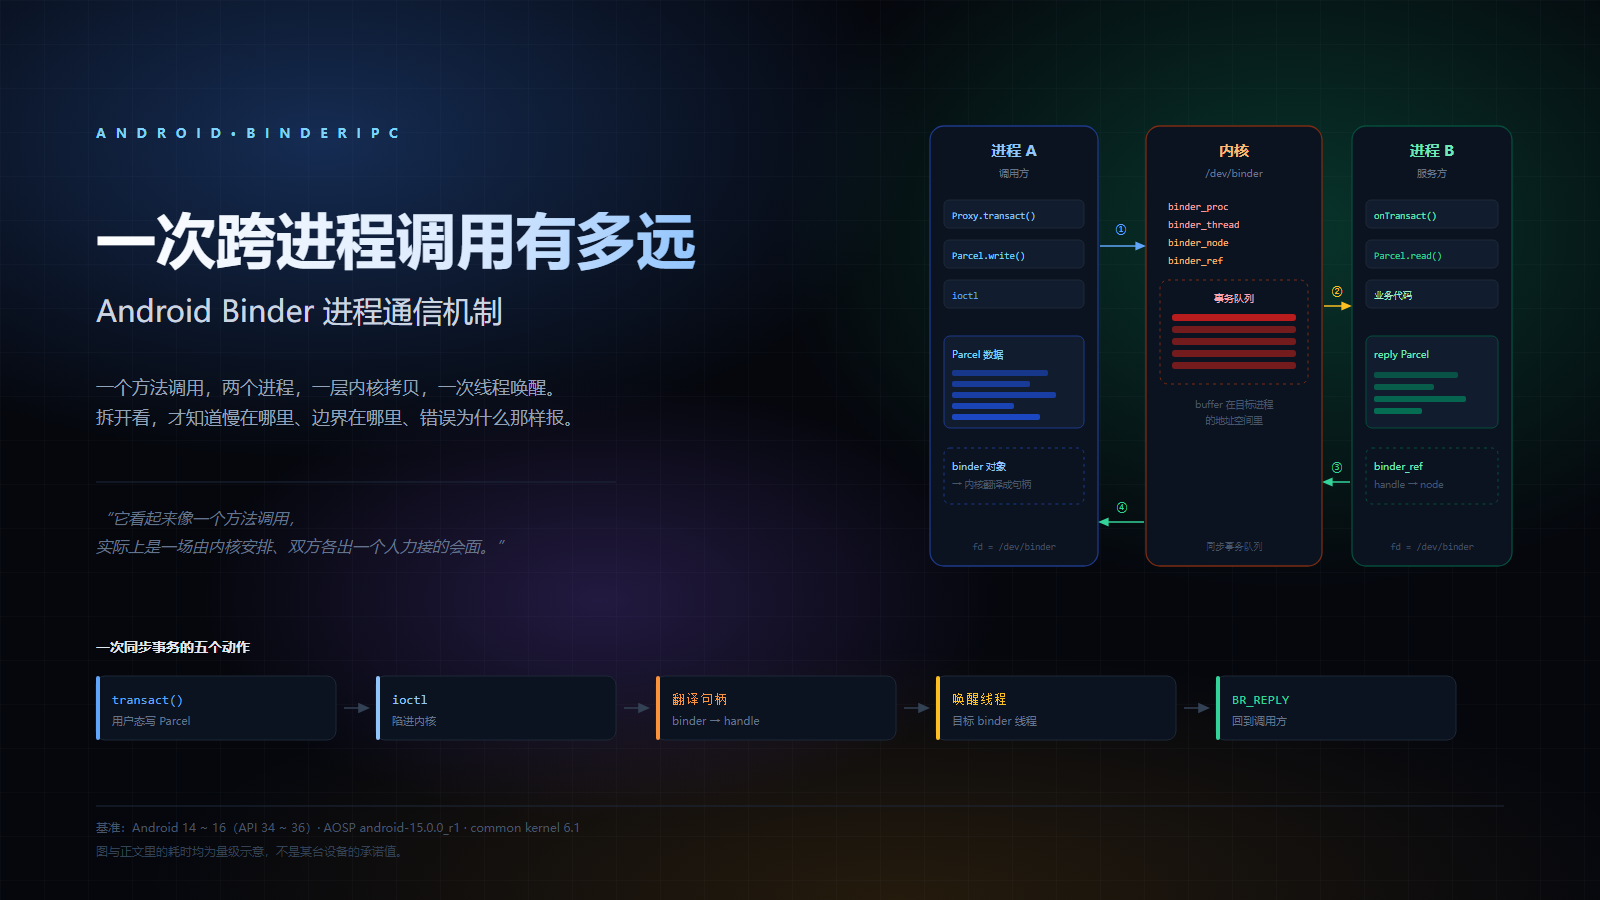
凌晨一点,排查一个线上 ANR。trace 里主线程停在:
"main" prio=5 tid=1 Blocked
  | group="main" sCount=1 ucsCount=0 flags=1 obj=0x72c8b4a0
  at android.os.BinderProxy.transactNative(Native method)
  at android.os.BinderProxy.transact(BinderProxy.java)
  at android.content.pm.IPackageManager$Stub$Proxy.getPackageInfo(IPackageManager.java)
  at android.app.ApplicationPackageManager.getPackageInfo(ApplicationPackageManager.java)
  at com.example.version.VersionChecker.check(VersionChecker.java:41)
出问题的这行代码本身平平无奇:
PackageInfo info = getPackageManager().getPackageInfo(getPackageName(), 0);没有线程池、没有 IO、没有回调,读起来就是一次普通的方法调用。可它在主线程上停了 2.3 秒。
这 2.3 秒不是被 getPackageInfo 这一行“执行”掉的。它被切成很多段:主线程把参数写进 Parcel、通过 ioctl 陷进内核、内核在 system_server 的地址空间里找出一块 buffer、把数据拷进去、叫醒 system_server 的一条 binder 线程、那条线程排队等 PackageManagerService 的锁、处理完再把 reply 沿原路送回来。主线程在等其中的每一段,而它自己什么也没做。
这就是 Binder 的日常:Android 里几乎所有“看起来是本地方法”的 framework 调用,背后都是一次跨进程事务。startActivity、getSystemService、bindService、registerReceiver、写 SharedPreferences 的底层、WindowManager.addView、ClipboardManager 的每一次读写……全是它。
大多数讲 Binder 的文章停在“Binder 是一种 IPC 机制,通过 mmap 实现一次拷贝”这句话上。这句话没错,但它解释不了三件事:为什么一次调用要牵扯两个线程池、为什么异常总在奇怪的地方报、为什么明明只传了几百 KB 却收到 TransactionTooLargeException。要把这些说清楚,得把链路铺开,落到具体的结构体、函数和线程上。
下面按一次真实调用的顺序走:先看两侧的栈,再看内核里的账本,然后完整走一遍事务,最后谈并发、生命周期、边界和观测。版本差异会标出来;没有特别说明时,以 Android 15 的 AOSP 和 common kernel 6.1 为准。
1. 先分清三个“Binder” 链接到此标题
“Binder”这个词在 Android 里至少指三样东西,混着用会让讨论迅速变形。
android.os.Binder类:Java 层的一个类,服务端继承它(或继承 AIDL 生成的Stub,Stub再继承它),表示“我是一个可以被跨进程调用的对象”。- Binder 驱动:内核里的一套字符设备(
/dev/binder),负责搬数据、登记对象、维护引用、唤醒线程。它不认识 Java 接口,也不认识 AIDL。 - Binder IPC 机制:上面两者加上 servicemanager、libbinder、AIDL 生成代码、SELinux 策略,共同构成 Android 的默认进程间通信方案。
这三者的边界必须分清。比如“Binder 调用是同步的”这句话,准确的说法是:Binder 驱动层面,同步事务(非 TF_ONE_WAY)会让调用线程阻塞到回复到达;而 Java 层可以在这之上做异步封装(oneway 只是其中一种)。再比如“Binder 一次拷贝”说的是驱动把数据从发送方用户态拷进接收方的 mmap 区,与 Java 层的 Parcel 怎么序列化没有关系。
1.1 三个视角看到的同一个调用
同一个 getPackageInfo,在三个地方看是三副样子。
写代码的人看到的是一个接口:
// 应用侧
PackageInfo info = getPackageManager().getPackageInfo(pkg, 0);
libbinder 看到的是一次事务:BpBinder 拿着 handle(比如 42),把 code、flags、Parcel 交给 IPCThreadState,后者用 ioctl(BINDER_WRITE_READ) 陷进内核,然后阻塞等待 BR_REPLY。
驱动看到的是一组结构体:哪个 binder_proc、哪个 binder_thread、目标 binder_node 是谁、在目标进程的 binder_alloc 里切出多大的 binder_buffer、offsets 里有哪些对象需要翻译。
这三层之间没有“翻译”,只有约定:AIDL 生成的两侧代码约定事务码、接口 token 和字段顺序;libbinder 约定 Parcel 如何变成 binder_transaction_data;内核约定 flat_binder_object 如何被改写为 handle。任何一层错位,表现都是“调用失败”或“读到垃圾数据”,但原因可能完全不同。
1.2 为什么说它是“被设计成看起来像本地调用”
从软件工程角度,Binder 做的最重要的一件事,是把“跨进程”包装成“本地对象调用”:
- 客户端拿到的是一个接口实现(AIDL 生成的
Proxy),调用它的方法就像调用本地对象; - 服务端实现的是一个接口(
Stub的子类),onTransact负责把字节流还原成方法参数; - 对象可以在进程之间传递(
Parcel.writeStrongBinder),到了对面变成可调用的代理; - 权限检查、生命周期、死亡通知都在框架里完成,业务代码通常感知不到。
这套包装非常成功,成功到很多 Android 开发者写了几年代码,也没意识到自己每天都在做 IPC。代价是:一旦出问题,问题会出现在离你很远的地方——内核的 buffer 分配、另一个进程的线程池、SELinux 的策略文件。后面第 10、12、13 节基本都在处理这类“离得很远的问题”。
1.3 本文的路线
整条链路可以切成五段,后面按这个顺序展开:
| 段 | 发生了什么 | 对应章节 |
|---|---|---|
| ① 接口与代理 | AIDL 生成 Proxy / Stub,方法调用变成 transact(code, parcel, reply, flags) | 第 7 节 |
| ② 陷入内核 | ioctl(BINDER_WRITE_READ),交出 write buffer 和 read buffer | 第 4、5 节 |
| ③ 内核事务 | 查 node/ref、分配目标 buffer、拷贝数据、翻译对象、入队唤醒 | 第 3、4、5 节 |
| ④ 服务端执行 | 目标 binder 线程取出事务,onTransact 分发到业务代码 | 第 7、8 节 |
| ⑤ 回程 | BC_REPLY → BR_REPLY,调用方线程醒来 | 第 5、8 节 |
在这五段之外,还有三件事贯穿始终:服务发现(第 6 节)、对象生命周期(第 9 节)、资源边界(第 10 节)。
2. 两个地址空间之间:为什么必须有内核经手 链接到此标题
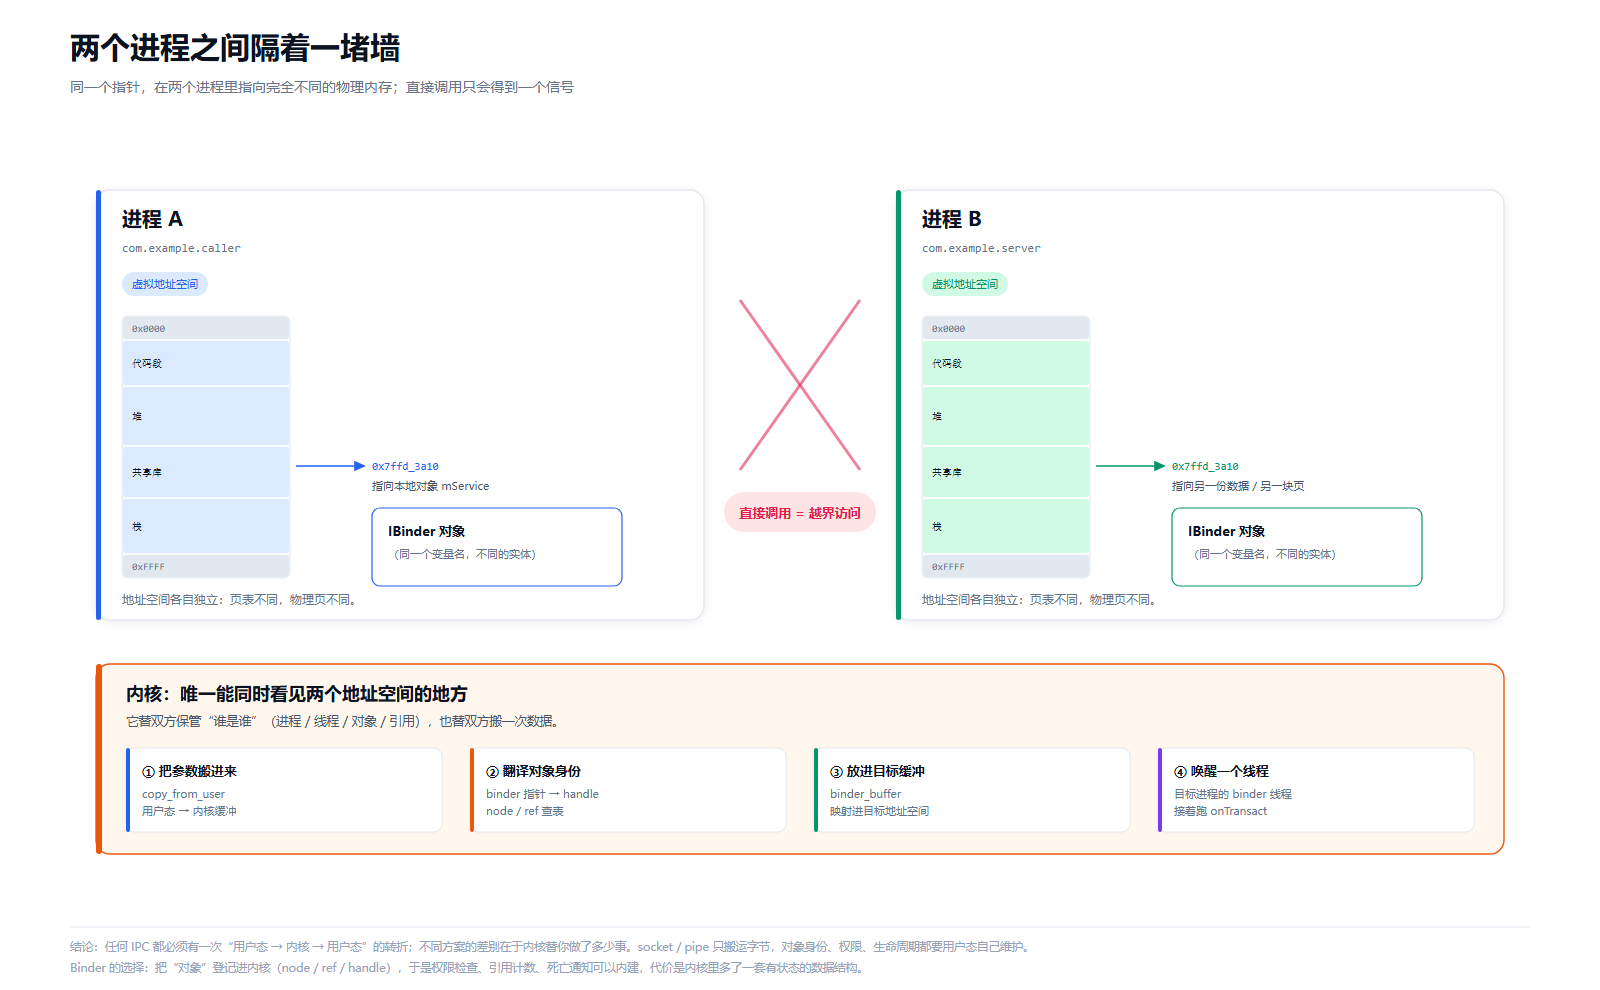
先把最基本的事实摆清楚:在 Linux 上,两个进程不能直接调用对方的函数。
每个进程有自己的虚拟地址空间和页表。进程 A 里有一个指针 0x7ffd_3a10,它指向 A 的某一页物理内存;进程 B 里同样可以有一个“地址等于 0x7ffd_3a10”的变量,但它经过 B 的页表翻译后,落到完全不同的物理页上。两个进程共享的只有 CPU 和内存条,不共享地址空间。
所以 A 想把一个对象“交给” B,只有几条路:
- 把数据写到一个双方都能访问的地方(共享内存、文件),再想办法通知对方;
- 通过内核提供的 IPC 通道(pipe、socket、消息队列、binder)把数据交给内核,由内核转交;
- 让内核把 A 的某一页映射进 B 的地址空间(
mmap,共享内存的本质)。
这三条路里,通知和同步几乎总要经过内核:进程自己无法唤醒另一个进程的线程,也无法安全地修改对方的页表。这就是为什么所有 IPC 方案都有一次“用户态 → 内核 → 用户态”的转折。
2.1 一次转折里,内核至少要干三件事
不管用哪种 IPC,内核至少要完成:
- 搬运:把数据从发送方拷到某个能到达接收方的地方(内核缓冲、共享页、文件)。
- 定位:知道该交给谁(进程、线程、socket、binder 节点)。
- 同步:让接收方知道有东西可读,并在需要时阻塞发送方。
区别在于,内核还“额外”知道多少语义。pipe 和 socket 只知道字节流和外层的 fd;共享内存只知道页的映射关系;而 Binder 在内核里维护了一套对象系统:谁是服务端对象、谁持有它的引用、引用计数多少、进程死了要通知谁。
这套“额外知识”是 Binder 与 socket 最本质的差异,也是它复杂的根源。
2.2 为什么不用 socket 或共享内存
Android 并不是没有 socket——Zygote 就用 socket 接收 fork 请求,LocalSocket 至今被大量使用。但 framework 进程之间的调用没有选它,原因不是“socket 慢”这么简单。
| 维度 | socket / pipe | 共享内存 | Binder |
|---|---|---|---|
| 数据拷贝 | 两次(发送方→内核,内核→接收方) | 零次(映射后直接读写) | 一次(发送方→接收方 mmap 区) |
| 对象身份 | 没有,只有字节和 fd | 没有,需要自己定义结构 | 有,node / ref / handle 由内核维护 |
| 调用者身份 | 需要自己传(SO_PEERCRED 等) | 无 | 内核在事务里填 sender_pid / sender_euid |
| 权限检查 | 自己实现 | 自己实现 | SELinux 在驱动与 servicemanager 处检查 |
| 生命周期通知 | 自己实现(EOF、心跳) | 自己实现 | 内建死亡通知(linkToDeath) |
| 调用语义 | 字节流,无“调用”概念 | 无 | 同步 RPC、oneway、事务码、回复 |
| 典型用途 | Zygote、日志、本地服务 | 图形 buffer、大块数据 | framework 服务调用、系统服务、HAL |
对 Android framework 来说,“对象身份 + 调用者身份 + 生命周期”这三件事是刚需。AMS 必须知道是谁在调它(权限检查),必须能持有一个服务的代理(引用计数),必须知道服务死没死(清理状态)。这些如果都让每个服务自己用 socket 实现一遍,重复且容易出错,更难和 SELinux 策略统一。Binder 把这三件事下沉到了内核和少数几个用户态组件里。
代价也很清楚:内核里多了一套有状态的数据结构,它有自己的锁、自己的内存上限、自己的故障模式。第 3、4、10 节讲的就是这些代价。
2.3 一次调用的“隐含成本”从这里开始
把 A 调用 B 拆成最基本的形式,至少包含:
- A 的一次用户态 → 内核态切换(
ioctl); - 内核里的一次查找与一次内存拷贝;
- 一次目标线程唤醒(可能伴随调度延迟);
- B 的一次内核态 → 用户态切换;
- 回程再来一轮。
即便数据只有几个字节,这条路径也要花掉几十微秒;数据大、目标忙、线程池满,就会涨到毫秒甚至秒级。理解这一点之后,再看到“主线程卡在 transactNative 2.3 秒”,就不会觉得奇怪:它卡的根本不是那次调用本身,而是调用链条上所有等待的总和。
3. 两侧对称的栈:一次调用经过哪些层 链接到此标题
Binder 在用户态是一套“两侧对称”的栈。调用方和服务方各自的类名不同,但职责一一对应。
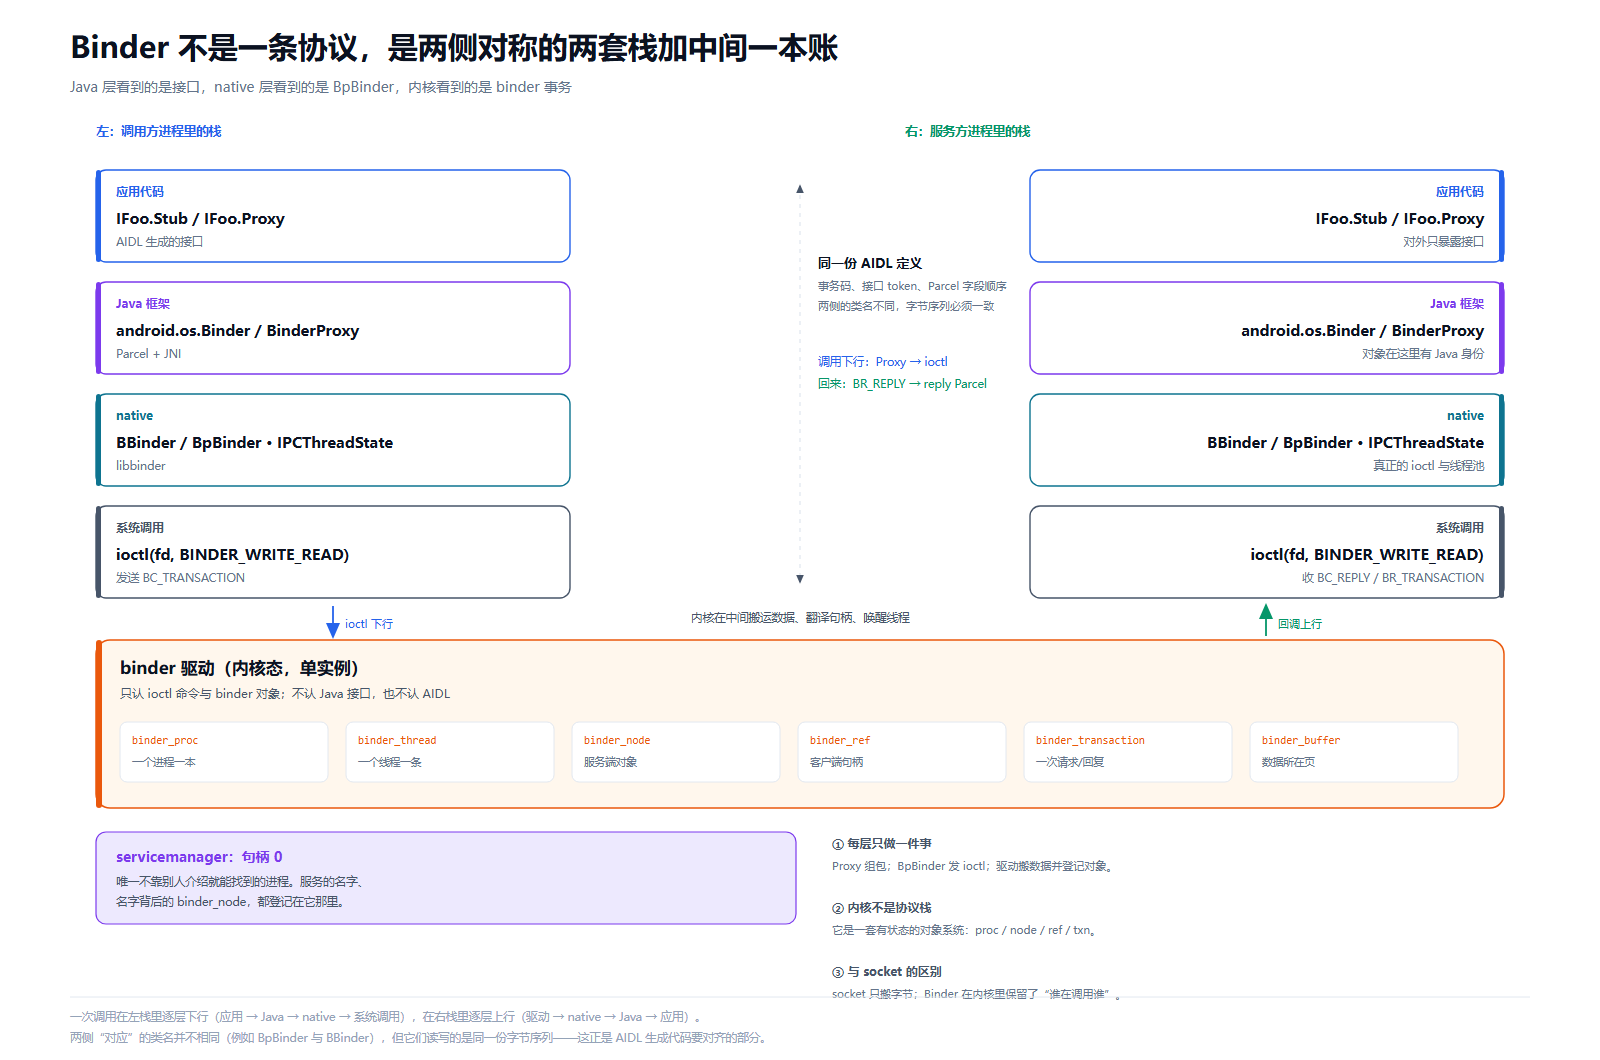
从下往上看:
| 层 | 调用方(客户端) | 服务方(服务端) | 职责 |
|---|---|---|---|
| 系统调用 | ioctl(fd, BINDER_WRITE_READ) | 同样的 ioctl | 进入驱动,交出/取回命令与回执 |
| libbinder | BpBinder、IPCThreadState、Parcel | BBinder、IPCThreadState、Parcel | 组包、发事务、等回复;收事务、分发 |
| Java 框架 | BinderProxy、Parcel | Binder(JavaBBinder) | JNI 桥接;Java 对象与 native 对象互指 |
| AIDL 生成 | IFoo.Proxy | IFoo.Stub | 事务码、接口 token、参数顺序 |
几个容易搞混的对应关系:
- Java 的
BinderProxy是一个 Java 对象,它与 native 的BpBinder一一对应。早期版本里有一个mObject字段直接指向它;Android 14/15 改成了mNativeData(一个 long),背后是BinderProxyNativeData,里面包着sp<IBinder>(即BpBinder)和死亡回调列表。对写代码的人来说没差别,BinderProxy.transact()最终仍然走android_util_Binder.cpp里的 JNI →BpBinder::transact()。 - Java 的
Binder也是一个 Java 对象,它在 native 侧对应一个JavaBBinder(BBinder的子类),后者持有 JavaBinder的全局引用(GlobalRef),所以这个 Java 对象不会因为“看起来没人用了”而被提前回收。JavaBinder里存的mObject指向的是JavaBBinderHolder,holder 用弱引用按需创建JavaBBinder。当服务端收到事务时,JavaBBinder::onTransact通过 JNI 回调到 Java 的Binder.execTransact。 Parcel在 Java 和 native 各有一个,二者共享同一块数据(Java 的Parcel持有 nativeParcel的指针)。跨进程传的永远是 nativeParcel里的字节。
再往下,就是驱动。驱动不认识 BpBinder,也不认识 IFoo,它只认识 binder_proc、binder_thread、binder_node、binder_ref 和 binder_transaction。
3.1 为什么两侧必须“对称”却“不同名”
因为两侧做的是不同的事:客户端把对象“翻译”成字节,服务端把字节“翻译”回对象。对称的是约定,不是代码。
这套约定由 AIDL 生成器保证:同一份 .aidl 文件,生成客户端 Proxy 和服务端 Stub,两边用同样的接口 token、同样的事务码、同样的字段顺序。任何一侧偷偷改了顺序(比如手写 Parcel 读写而没有同步改 AIDL),就会在运行时读到错位的数据——这是 Binder 调试中最常见的一类“不报错但结果不对”的问题。
3.2 servicemanager 站在栈之外
上面这套栈里没有出现“如何找到服务”。答案是:找到服务本身也是用 Binder 完成的——用固定的 handle 0 找到 servicemanager,再问它要名字对应的 handle。
servicemanager 是整套体系里唯一一个不用“被介绍”的进程,它的句柄固定为 0。第 6 节会展开。
4. 内核里的账本:五类对象和一组索引 链接到此标题
Binder 驱动在 Android 内核里是一个 misc 设备,设备节点是 /dev/binder(Android 10 之后常见的是 /dev/binderfs 下的 binderfs 设备,见第 10 节)。它维护的核心数据结构不多,但每一个都有明确的职责。
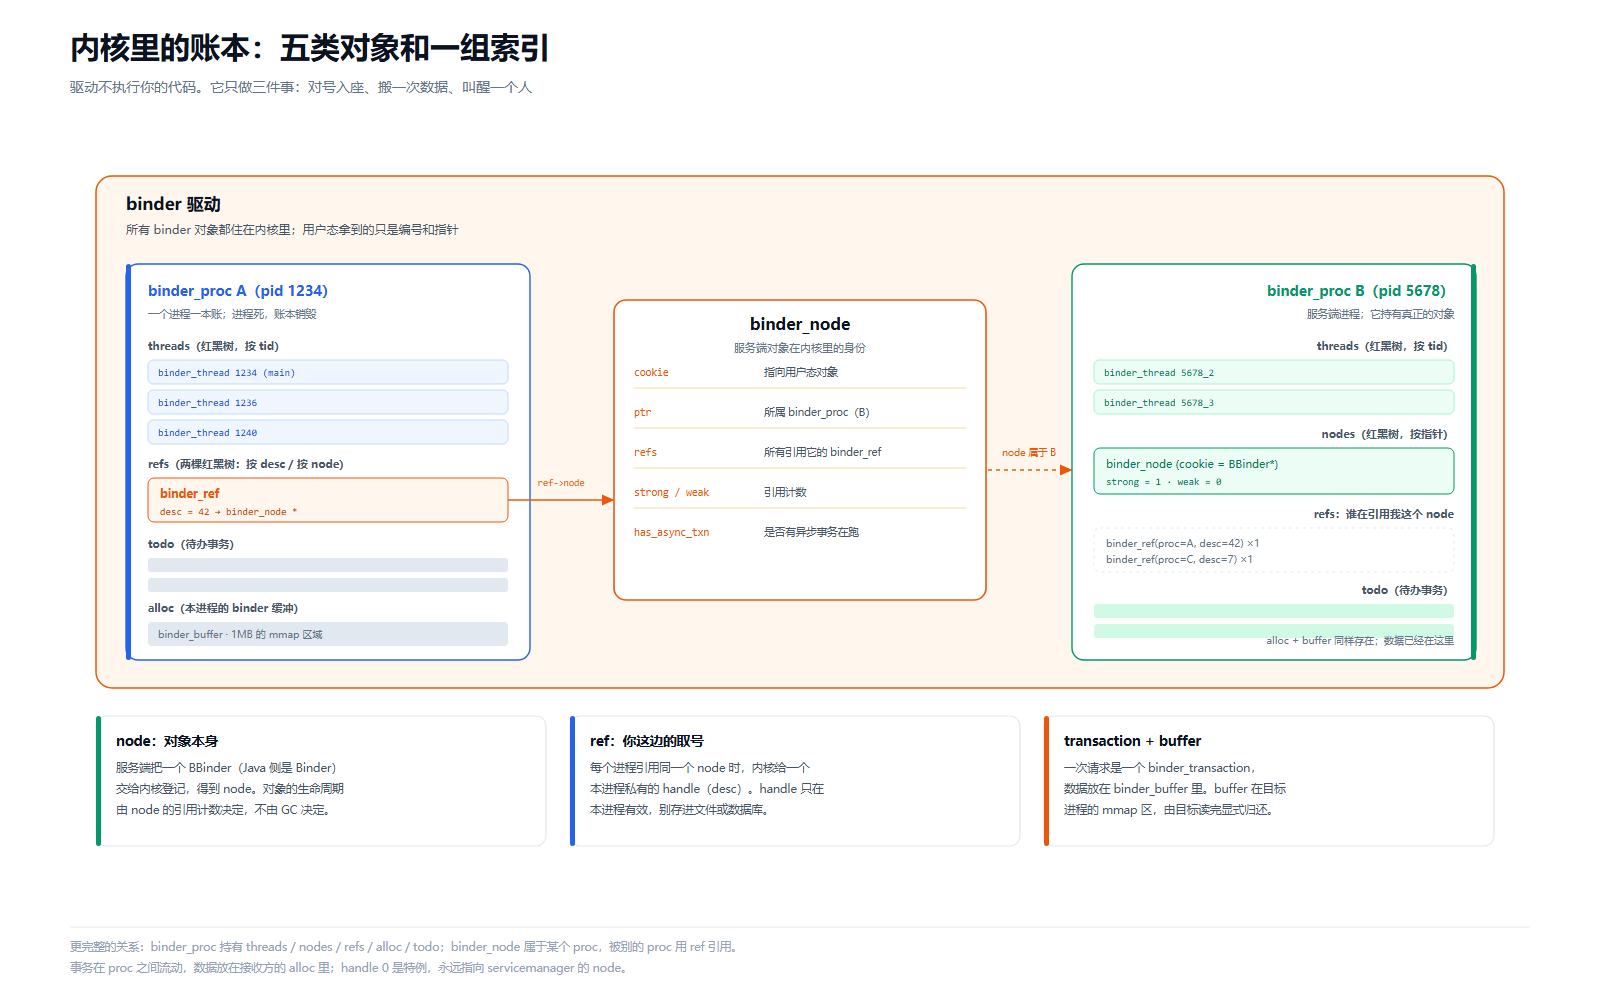
| 结构 | 归属 | 作用 | 查找方式 |
|---|---|---|---|
binder_proc | 每个打开驱动的进程一个 | 该进程的线程、节点、引用、缓冲区、待办事务的总账 | 全局表 / 按 pid 索引 |
binder_thread | 每个与驱动交互的线程一个 | 该线程的读缓冲、事务栈、等待状态 | 按 tid 的红黑树,挂在 proc 下 |
binder_node | 服务端对象在内核里的身份 | 对象本体、cookie、强/弱引用计数、所属 proc | 按指针的红黑树(全局) |
binder_ref | 客户端对某个 node 的引用 | handle 到 node 的映射,强/弱引用 | 按 handle(desc)的红黑树,挂在 proc 下 |
binder_transaction | 一次事务 | 发起线程、目标线程、code、flags、数据位置 | 挂在事务栈 / 待办队列上 |
binder_buffer | 一次事务的数据区 | 在目标进程 mmap 区里切出的一块内存 | 挂在 proc 的 alloc 上 |
4.1 node / ref / handle:三个词说清“对象”
这是理解 Binder 最关键的一组概念,值得单独展开。
- node 是对象本身。服务端把一个
BBinder(Java 层是Binder)交给内核,内核为它建一个binder_node。这个 node 全局唯一,属于服务端进程,它的cookie指回用户态那个BBinder。 - ref 是“借条”。当另一个进程需要通过 Binder 引用这个对象时,内核在那个进程的
binder_proc里建一个binder_ref,指向 node。 - handle 是 ref 的编号。
binder_ref->desc就是用户态看到的句柄,一个进程内唯一的 32 位整数。BpBinder里存的就是这个数。
所以“客户端持有服务端对象”这个说法,严格来讲不成立。客户端持有的是一个整数编号,加一个本地代理对象;真正让这个编号有意义的是内核里那条 ref → node 的记录。值得一提的是,每条 ref 同时挂在两棵红黑树上:一棵按 handle 排序(进程内按编号查找),一棵按 node 指针排序(同一对象复用同一条 ref)。这两个索引方向,正好对应内核里“我知道 handle,想知道是谁”和“我知道 node,想知道这个进程有没有引用过”两种需求。
这也解释了几个常见现象:
- handle 只在创建它的进程里有效。把 handle 存进文件、写进数据库、传给第三个进程,都是无意义的。
- 同一个 node 可以被多个进程引用,每个进程拿到的 handle 值可以不同(由内核按该进程的空闲号分配)。
- 服务端进程死亡时,node 先被标记为 dead(不是立刻释放),注册过死亡通知的 ref 会收到
BR_DEAD_BINDER;等所有 ref 消失,node 才真正释放(第 9 节)。
4.2 handle 0 为什么特殊
handle 0 永远有效,而且不需要事先建立引用:内核在 binder_transaction 里对 target handle 0 做特殊处理——它不去查进程私有的 ref 表,而是直接取 context manager 的 binder_context_mgr_node(servicemanager 的 node)。换句话说,handle 0 不是“某个进程的 ref”,是内核内置的一个约定。
这意味着:任何进程,不需要先知道任何服务,就能向 servicemanager 发请求。这是整套服务发现能启动起来的前提。
4.3 一条流水线:事务如何流动
内核处理一次事务,抽象来看是五步:
- 从
binder_write_read.write_buffer里解析出BC_TRANSACTION; - 根据 target handle 找到目标 node 和它的
binder_proc; - 在目标进程的
binder_alloc里分配一块binder_buffer,把数据拷进去; - 遍历 offsets,把
flat_binder_object翻译成目标进程视角的 handle; - 把事务挂到目标进程/线程的待办队列,唤醒一个等待中的线程。
这五步在第 5 节会逐函数展开。这里先记住一个结论:内核不做业务判断,只做对象翻译和搬运。code 是谁、业务是什么、reply 里放什么,它一概不管;它只保证把这些字节安全地送到正确的人手里,并维护对象关系的正确性。
4.4 锁与并发:账本不是免费的
这些数据结构要被多个 CPU 上的多个线程同时访问,驱动里因此有一组锁:每个 proc 内部有自己的锁、每个 node 有 node 锁、引用计数用原子操作,全局的 proc 表也有自己的锁。
锁的顺序和粒度直接决定了大并发下的表现。比如一个进程在 binder_transaction 里要查目标 node、分配 buffer、修改 ref 计数,中间需要拿多把锁;如果此时另一个 CPU 上的线程也在操作同一个 proc,就会产生竞争。这也是为什么 system_server 这种“所有进程都来找它”的进程,在压力下会显得迟钝——它不只要处理业务,还要在内核里处理成百上千条事务的排队与锁竞争。
4.5 mmap:为什么 buffer 在接收方
一个常被忽略的细节:事务数据不是放在“内核缓冲区”里等接收方来取,而是放在接收方进程自己 mmap 出来的那块区域里。
binder_mmap 在进程打开驱动时建立一块虚拟地址区域(libbinder 侧默认约 1MB);驱动用 binder_alloc 管理这块区域,把它切成一个个 binder_buffer。发送方发事务时,驱动在接收方的 alloc 里分配 buffer,然后把数据从发送方用户态拷进去。
这么做的好处是:接收方读数据时不需要再拷一次——数据已经在自己的地址空间里。这就是“一次拷贝”的实现方式,第 5 节细说。
坏处也很直接:这块区域的大小就是单个进程的并发事务总量上限;分配不到时,事务直接失败。TransactionTooLargeException 的根在 Binder,不在 Java 的 Parcel 里。
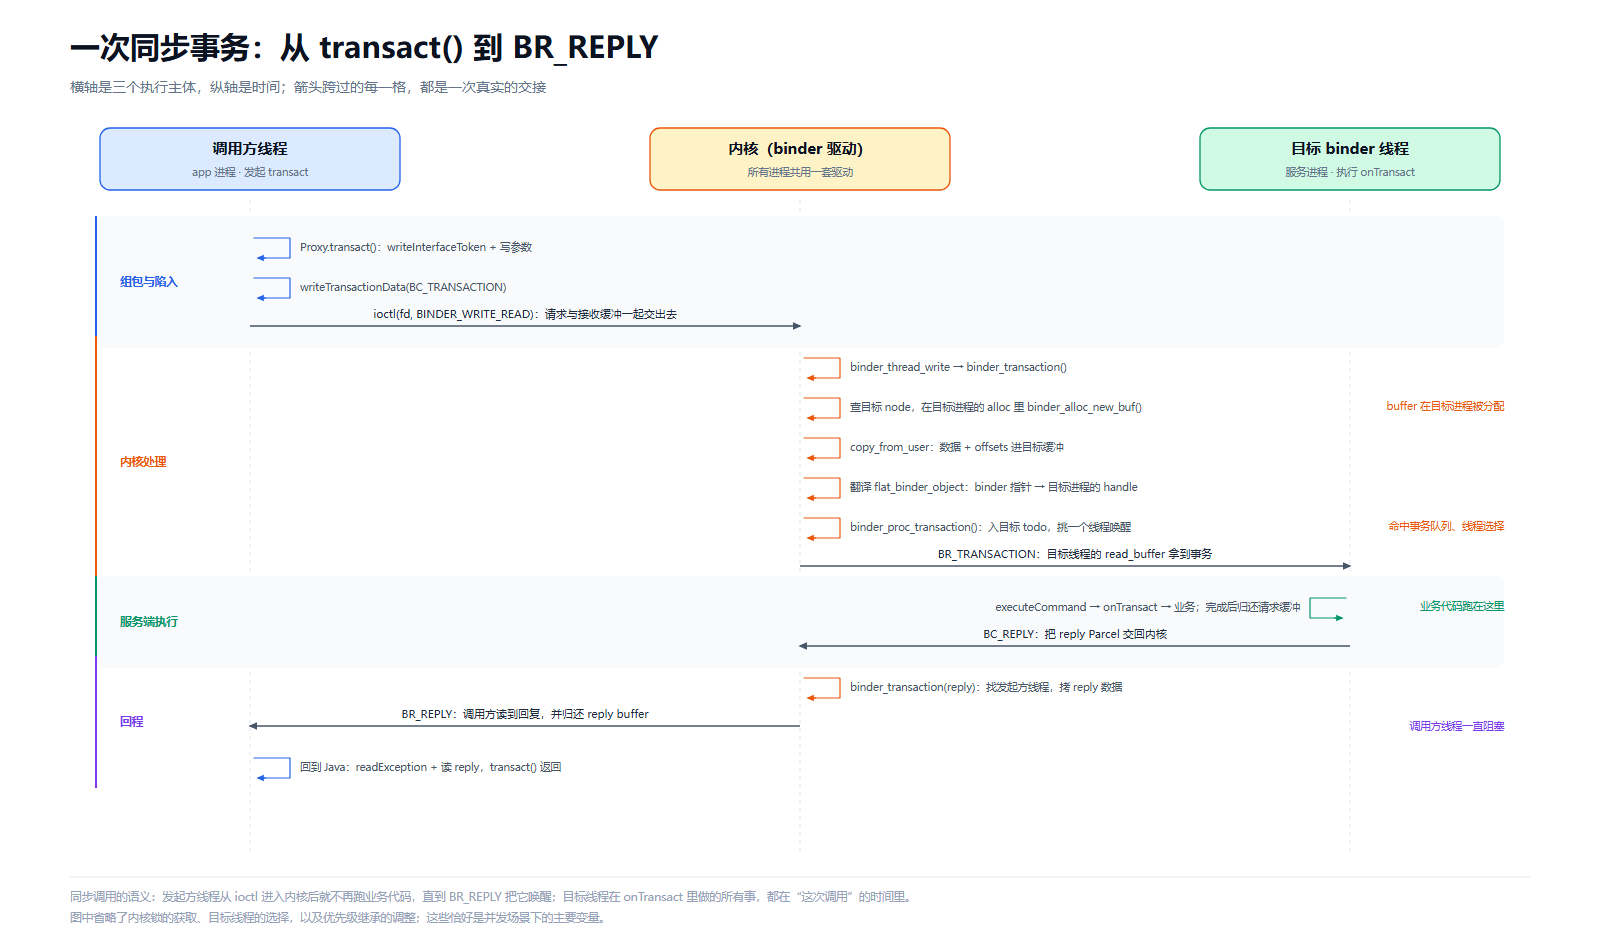
5. 一次事务的完整路径 链接到此标题
现在把镜头拉近,跟一次 getPackageInfo 走完全程。
5.1 用户态:从接口调用到一次事务数据
AIDL 生成的 Proxy 做三件事:写接口 token、按顺序写参数、发事务。
// IFoo.Proxy(AIDL 生成代码的结构)
@Override
public void doIt(int x) throws RemoteException {
    Parcel data = Parcel.obtain();
    Parcel reply = Parcel.obtain();
    try {
        data.writeInterfaceToken(DESCRIPTOR);   // 服务端用它校验接口
        data.writeInt(x);                        // 参数,按 AIDL 声明顺序
        mRemote.transact(TRANSACTION_doIt, data, reply, 0);
        reply.readException();                   // 服务端抛的异常在这里重抛
    } finally {
        data.recycle();
        reply.recycle();
    }
}
mRemote 是一个 IBinder,实际类型是 BinderProxy。它的 transact 走到 JNI,进 BpBinder::transact,再进 IPCThreadState::transact。
IPCThreadState 是每个线程一份的单例(用 pthread_getspecific 存着)。它有两个关键缓冲:mOut(要发给驱动的命令)和 mIn(从驱动读回的命令)。发送时它做两件事:
writeTransactionData(BC_TRANSACTION, flags, handle, code, data, nullptr):把事务头写成binder_transaction_data,追加到mOut。这个结构里有目标 handle、事务码、flags、数据大小、数据指针、offsets 指针。注意这里的指针还是发送方用户态地址,只在这一次 ioctl 里有意义。waitForResponse(reply)(同步事务):把mOut交给驱动,阻塞读回执,直到看到BR_REPLY(或错误)。
如果 flags 带了 IBinder.FLAG_ONEWAY,第 2 步换成 waitForResponse(nullptr, nullptr):写入命令、读到 BR_TRANSACTION_COMPLETE(或入队失败的错误),函数直接返回。
5.2 ioctl:一次系统调用,两个方向
libbinder 和驱动之间的唯一接口是 ioctl,参数是 binder_write_read:
struct binder_write_read {
    binder_size_t write_size;      // mOut 里有多少字节要交给驱动
    binder_size_t write_consumed;  // 驱动实际吃了多少(回填)
    binder_uintptr_t write_buffer; // mOut 的用户态地址
    binder_size_t read_size;       // 我这次准备接收多少字节
    binder_size_t read_consumed;   // 驱动实际写了多少(回填)
    binder_uintptr_t read_buffer;  // mIn 的用户态地址
};
一次 ioctl(fd, BINDER_WRITE_READ, &bwr) 同时完成“向下发命令”和“向上收回执”。这种设计是为了省系统调用:如果每次都发一次、收一次,开销会翻倍。
IPCThreadState::talkWithDriver 里是一个循环:把 mOut 交给驱动,读回 mIn;如果 read_consumed 为 0 说明这次没拿到事务,就继续等(同步事务在 waitForResponse 里等,普通线程在 joinThreadPool 里等)。
5.3 内核:binder_transaction 做了什么
驱动收到 BC_TRANSACTION,进入 binder_transaction()。这个函数是 Binder 内核侧的核心,做的事可以分成六步:
- 找到目标。根据
tr->target.handle在发起进程的refs红黑树里查出binder_ref,再得到binder_node和它所属的binder_proc。handle 0 走特殊路径,直接取binder_context_mgr_node。 - 分配接收缓冲。调用
binder_alloc_new_buf(&target_proc->alloc, data_size, offsets_size, ...),在目标进程的 mmap 区里切出一块binder_buffer。切不出来就返回-ENOSPC。 - 拷贝数据。把发送方用户态的 data 和 offsets 分别拷进目标 buffer(新内核里是
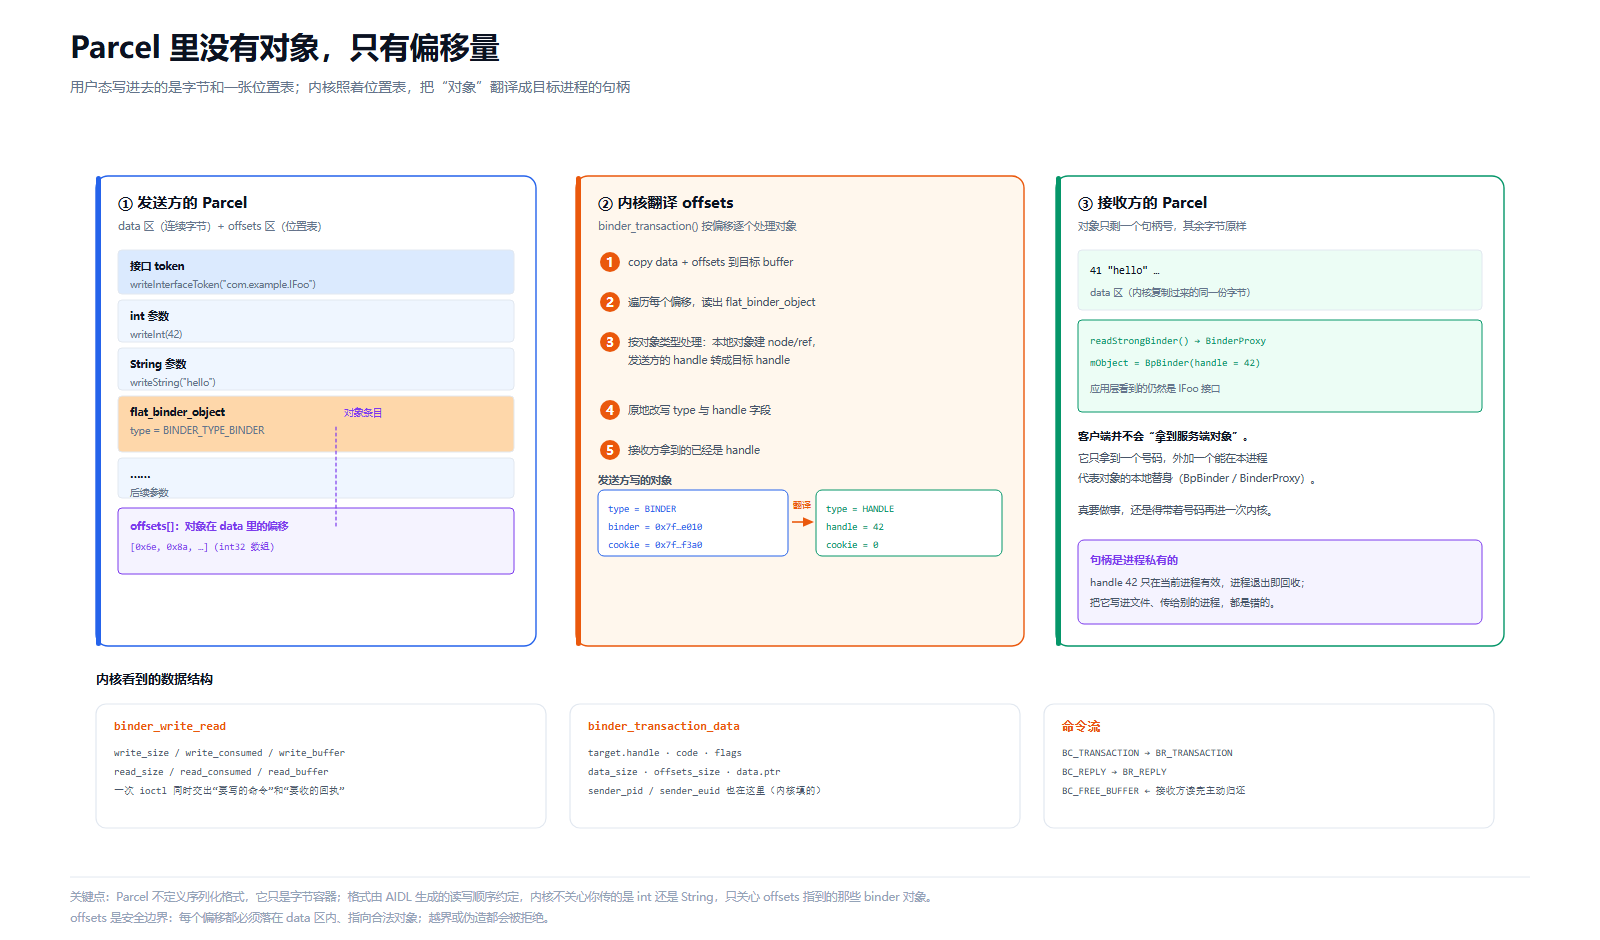
binder_alloc_copy_user_to_buffer,核心仍是copy_from_user)。这是请求数据在整条链路上唯一的一次内核拷贝。 - 翻译对象。遍历 offsets 数组,对每个
flat_binder_object调用binder_translate_binder(本地对象→node 引用)、binder_translate_handle(handle→目标进程的 handle)或binder_translate_fd(文件描述符→目标进程的 fd 号)。翻译结果原地改写在目标 buffer 里。 - 登记事务。填好
binder_transaction(发起线程、目标线程、code、flags、sender_pid、sender_euid、buffer 指针),调用binder_proc_transaction():如果目标线程正在等,就把它唤醒;否则把事务挂到目标 proc 或线程的待办队列。 - 回执。对同步事务,发起线程这次 ioctl 不会立刻拿到“已收下”的回执:
BR_TRANSACTION_COMPLETE被作为延迟工作挂在发起线程上,直到 reply(或错误)出现时,它才和BR_REPLY一前一后回到用户态。在那之前,线程一直阻塞在waitForResponse里。
注意第 5 步里的 sender_pid 和 sender_euid:它们由内核从当前 task 结构里直接填,不来自用户态。这是 Binder.getCallingUid() 可信的原因,也是权限检查的基础(第 10 节)。
5.4 offsets:Parcel 里的“对象”是怎么被翻译的
Parcel 本身不定义对象类型。它只是字节容器;当你要传一个 IBinder 时,writeStrongBinder 会在 data 里写一个 flat_binder_object,并在 offsets 数组里记下它的位置:
struct flat_binder_object {
    struct binder_object_header hdr;  // type + flags
    binder_uintptr_t binder;          // 用户态对象指针(发送方视角)
    binder_uintptr_t cookie;          // 附加指针(发送方视角)
};
offsets 是 int32 数组,每个元素是“对象条目在 data 区中的字节偏移”。内核只认 offsets,不关心 data 其余部分是什么格式——这是 Binder 能把“对象传递”做得通用、又不限制上层序列化方式的关键。
翻译的结果是:data 区里原来那个 {type=BINDER_TYPE_BINDER, binder=0x7f…, cookie=0x7f…},变成了 {type=BINDER_TYPE_HANDLE, handle=42, cookie=0}。接收方 Parcel.readStrongBinder() 读到 handle,构造 BinderProxy,mObject 指向 BpBinder(42)。
5.5 服务端:从 BR_TRANSACTION 到 onTransact
目标线程此时阻塞在 talkWithDriver 里(或者刚被唤醒)。驱动从 binder_thread_read 返回 BR_TRANSACTION,把事务的数据指针、code、flags 一起交给用户态。
libbinder 的 IPCThreadState::executeCommand 处理这条命令:
case BR_TRANSACTION: {
    binder_transaction_data tr;
    // tr 的位置、大小、code、flags 由驱动填好
    if (tr.target.ptr) {
        sp<BBinder> b((BBinder*)tr.cookie);
        error = b->transact(tr.code, buffer, &reply, tr.flags);
    }
    ...
}
BBinder::transact 会调用到具体对象的 onTransact。如果是 Java 服务,中间还有一层:BBinder 实际是 JavaBBinder,它的 onTransact 通过 JNI 回到 Java 的 Binder.execTransact,再由 AIDL 生成的 Stub.onTransact 按事务码分发:
// IFoo.Stub(AIDL 生成代码的结构)
@Override
public boolean onTransact(int code, Parcel data, Parcel reply, int flags) {
    switch (code) {
        case TRANSACTION_doIt: {
            data.enforceInterface(DESCRIPTOR);   // 接口 token 校验
            int x = data.readInt();              // 按声明顺序读参数
            this.doIt(x);                        // 业务代码
            reply.writeNoException();
            return true;
        }
    }
    return super.onTransact(code, data, reply, flags);
}业务代码(doIt)就在这条 binder 线程上执行。这一点后面第 8 节会反复用到:服务端回调在 binder 线程上,不在主线程,也不能假设它在哪个线程。
5.6 回程:reply、buffer 与一次唤醒
业务返回后,executeCommand 把 reply 写回驱动:
- 数据来自 reply
Parcel,BC_REPLY事务带着它重新进内核; - 内核这次的目标是“发起方线程”(记录在事务的
from里),在发起方进程的 alloc 里分配 reply buffer,拷贝数据; - 发起方线程从
BR_REPLY醒来,waitForResponse把 reply 数据读进 Java 的 reply Parcel; - 双方各自用
BC_FREE_BUFFER归还 buffer:服务端归还请求 buffer,客户端归还 reply buffer。
一次同步事务至此结束。发起线程从 transact() 返回,继续跑自己的代码;服务端线程回到 talkWithDriver,等下一个事务。
如果哪一步失败,表现会不一样:目标进程死了,驱动返回 BR_DEAD_REPLY(Java 层转成 DeadObjectException);buffer 分配不出来,返回 BR_FAILED_REPLY(Java 层抛哪个异常,取决于请求 Parcel 的大小,下一节细说);目标线程池满,事务就排队,发起方看起来只是“慢”。
5.7 一次拷贝到底省了什么
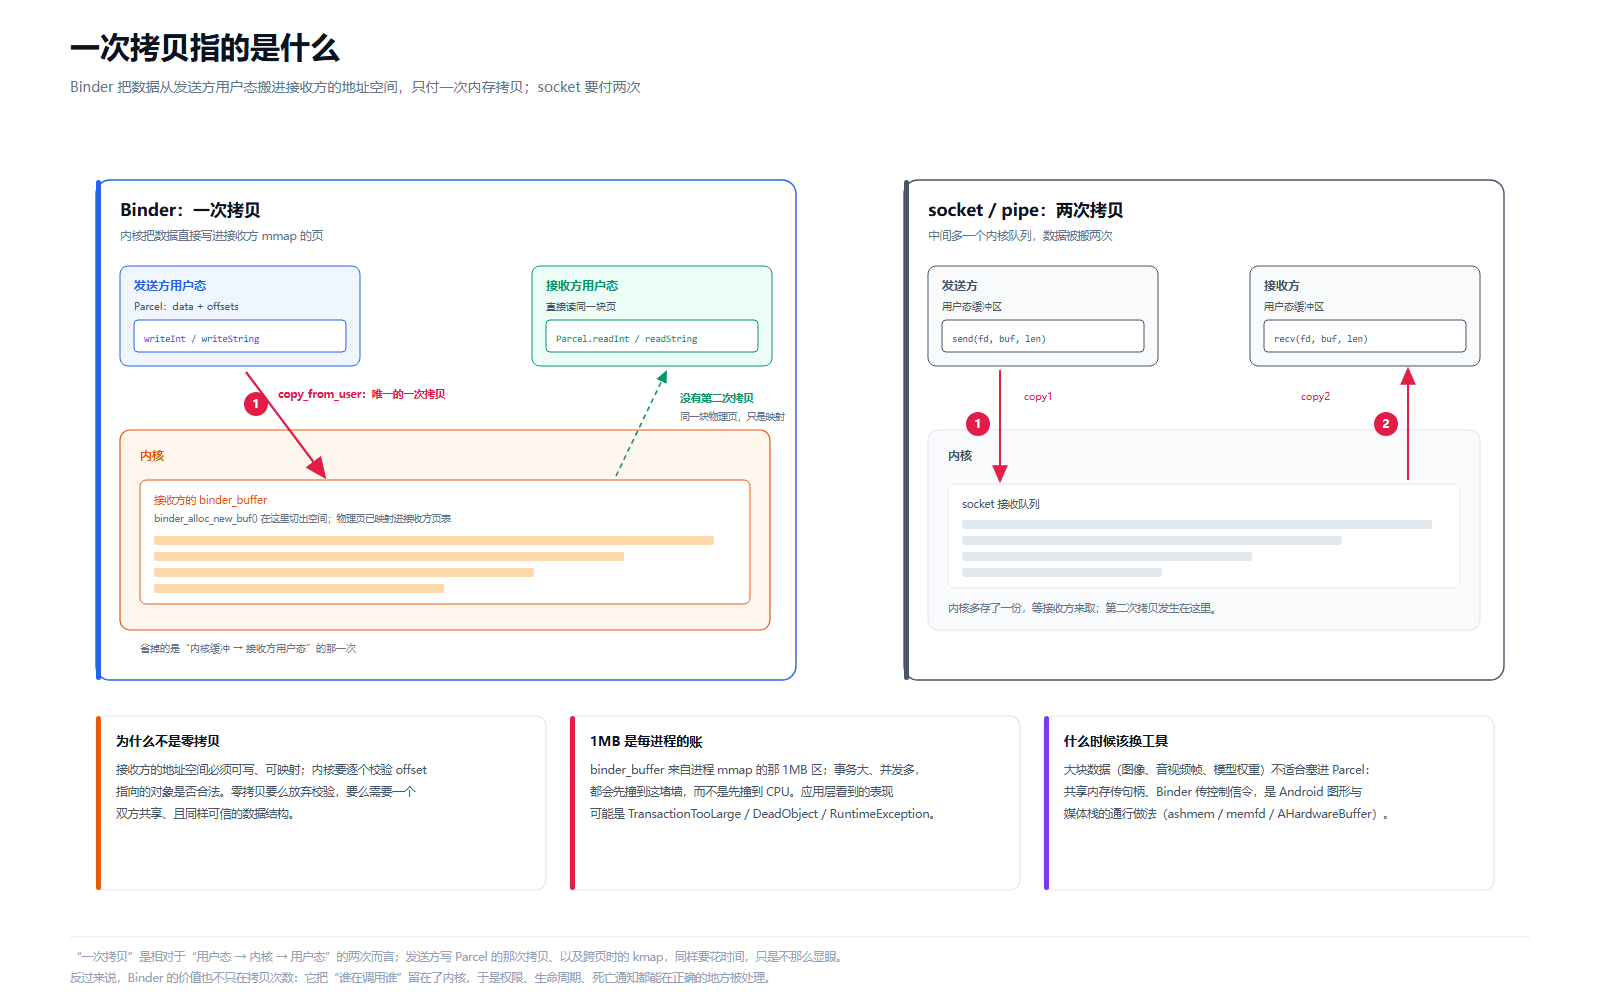
用 socket 传同样的数据,内核要:copy_from_user 把发送方数据搬进 socket 缓冲,copy_to_user 再搬给接收方。Binder 的巧处在第 2 步跳过:它把数据直接写进接收方进程的 mmap 区,接收方读的时候,数据已经在自己的地址空间里,不需要第二次拷贝。
所以“一次拷贝”的准确含义是:用户态数据只经过一次 copy_from_user。发送方写 Parcel 时的那次写(用户态内存到用户态内存)、跨页时的 kmap、offsets 的拷贝,都还存在,只是不显眼。
还有一个常被忽略的细节:接收方那块 mmap 区域是只读映射(PROT_READ)。用户态只能读它,写入完全由内核通过 kmap_local_page 完成。这也正是“一次拷贝”能成立的原因——发送方的页帧没有被 remap 到接收方,内核只能自己动手写一遍。
回程也一样省:libbinder 收到 BR_REPLY 后并不把数据复制进一个独立的 Parcel,而是用 ipcSetDataReference() 让 reply Parcel 直接引用内核映射区里的那块 buffer(连同 BC_FREE_BUFFER 的释放责任一起接管)。所以"读 reply"在用户态是零拷贝的,直到下次复用这块 buffer 才会改写。
这个设计还有一个副作用:接收方必须显式归还 buffer。Binder 没有 GC,buffer 的生命周期靠 BC_FREE_BUFFER 管理。如果用户态忘了还(比如进程崩溃、异常路径漏掉),那块缓冲就占着,直到进程退出。这也是为什么 Binder 用户态代码里 Parcel.recycle()、freeBuffer 这类调用必须走 finally。
5.8 oneway 的事务走哪条路
oneway 事务(IBinder.FLAG_ONEWAY,AIDL 里 oneway 关键字)在内核里被打上 TF_ONE_WAY,走一条短得多的路径:
- 发送方:写入
BC_TRANSACTION,读到BR_TRANSACTION_COMPLETE就返回,不阻塞、不等 reply; - 内核:照样分配目标 buffer、拷数据、翻译对象,但事务不绑定具体线程:优先投到目标 proc 的待办队列;同一个 node 上已经有 oneway 在飞时,后来的进
node的异步队列(async_todo)排队——这是 oneway 的“按 node 串行”; - 接收方:任何一条 binder 线程都可以取走它,执行
onTransact,然后直接归还 buffer(不用发 reply),归还时驱动再把队列里的下一条放出来; - 失败语义分两段:入队阶段的错误能看到(
BR_FAILED_REPLY、BR_DEAD_REPLY、BR_FROZEN_REPLY会在这次waitForResponse里返回);一旦成功入队,之后目标进程死掉或事务被丢弃,发送方不会再收到任何通知。
oneway 不等于“后台执行”。它省掉的是等待 reply 的时间,不省数据拷贝、不省线程切换、也不保证顺序之外的东西。把耗时操作放到 oneway 里,还是会在服务端线程上执行,只是调用方不等了——这是它最容易被误用的地方。
6. 谁在转发:servicemanager 与服务发现 链接到此标题
服务发现是 Binder 体系里最容易被讲得含糊的一段。常见说法是“服务通过 servicemanager 注册,客户端通过名字查找”,但具体是谁在查、查到了什么、权限在哪一步检查,决定了你能不能定位 getService 返回 null 的原因。
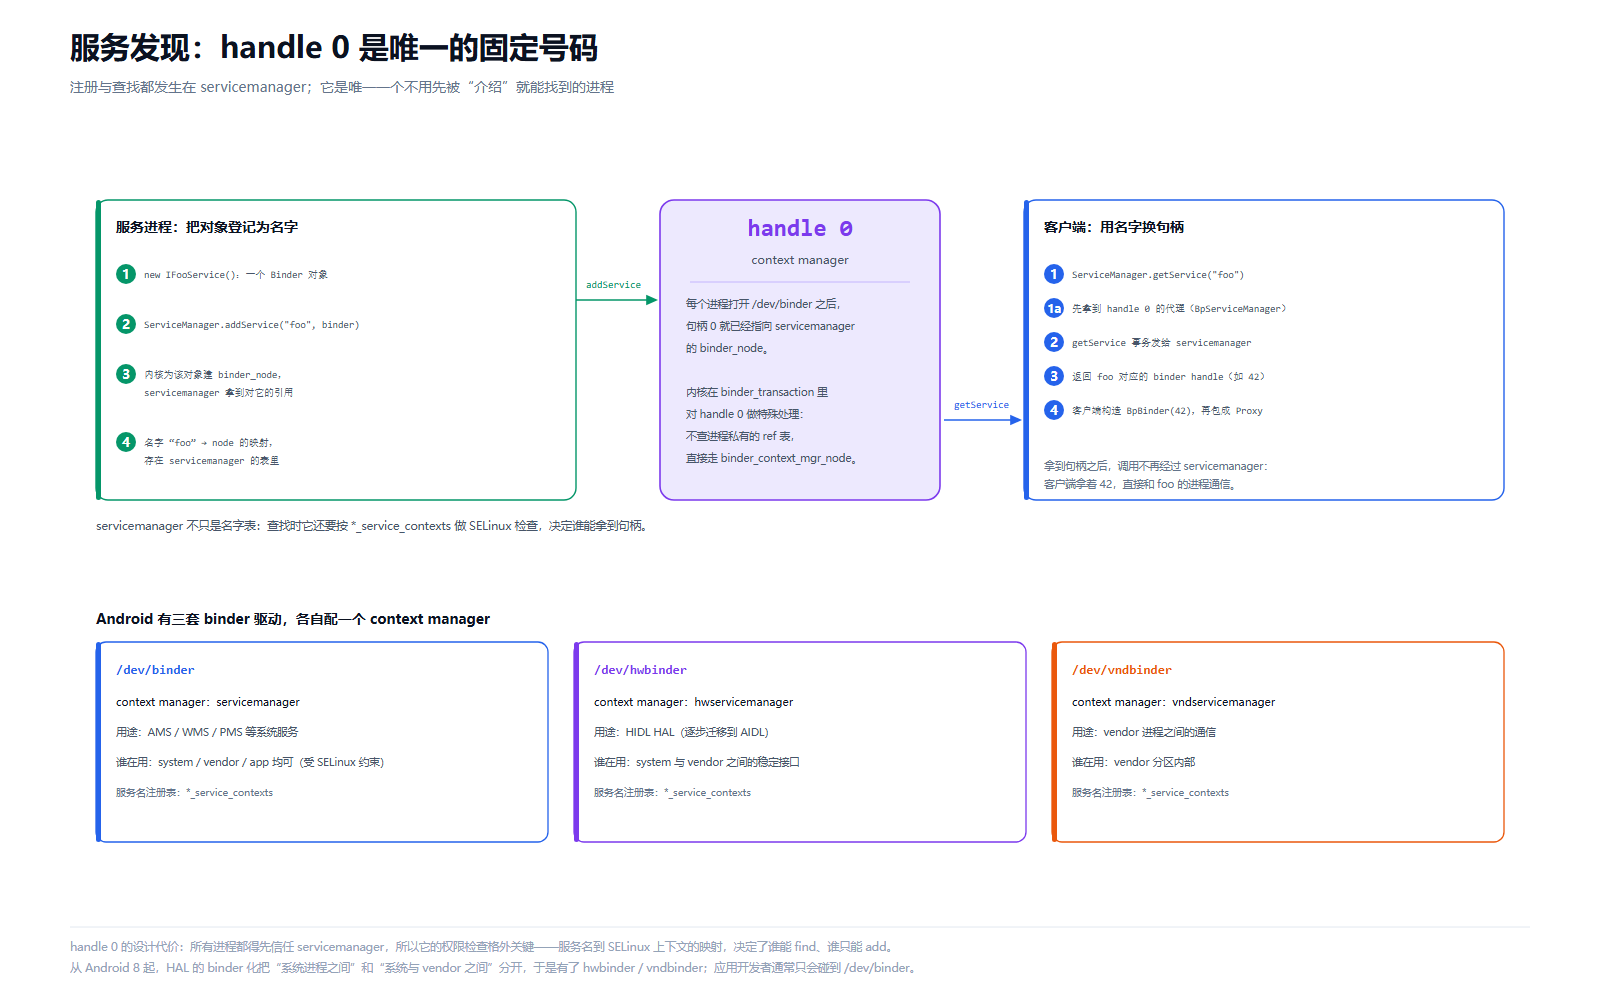
6.1 注册:把一个对象变成名字
服务进程启动时,通常在自己的 main 里做两件事:
// 伪代码:服务端注册
sp<IBinder> binder = new MyService();          // 或 Java 侧 new MyService()
defaultServiceManager()->addService(
        String16("myservice"), binder, /*allowIsolated=*/false);
addService 是一次 Binder 调用,目标是 handle 0(servicemanager 进程)。它携带了 binder 这个 IBinder(Parcel.writeStrongBinder),内核为服务端对象建 binder_node,并在 servicemanager 的 proc 里建一个 binder_ref。
servicemanager 收到后,在自己的表里记下“名字 → 这个 binder”。从这一刻起,任何进程只要向它要 myservice,它就能返回对应的句柄。
addService 不是无条件的:servicemanager 会拒绝应用 UID 注册服务(日志 App UIDs cannot add services.),服务名长度限制在 127 字节以内、字符集限定在字母数字与 _、.、-、/。这些规则看起来琐碎,但在排查“服务注册失败”时经常是关键线索。
注意:servicemanager 保存的是引用,不是数据副本。如果服务进程死了,内核把 node 标记为 dead、给持有者投死亡通知;servicemanager 在后续查询或清理时发现引用失效,getService("myservice") 就会返回 null(或抛异常,取决于查询方式)。
6.2 查找:用名字换句柄
客户端通常这样写:
IBinder b = ServiceManager.getService("activity");
IActivityManager am = IActivityManager.Stub.asInterface(b);
ServiceManager.getService 内部是一个静态缓存(sCache,ArrayMap)加一次 Binder 调用:
- 先看本进程缓存里有没有这个名字,有就直接返回;
- 没有就向 servicemanager 发
getService(name)(又一次 handle 0 调用); - servicemanager 返回目标服务的
IBinder(对客户端来说是一个新的 handle); - 客户端把它包成
BinderProxy,缓存起来。
拿到 handle 之后的调用不再经过 servicemanager:客户端直接拿着这个 handle 和服务进程通信。servicemanager 只在“解析名字”这一步出现。
getService 和 checkService 在底层几乎一样,唯一区别是 startIfNotFound:前者会触发动态(lazy)服务拉起,后者只查不启。HAL 大量使用这个机制——服务没被引用时不占进程,第一次 getService 才拉起。另外,进程第一次拿 handle 0 时,libbinder 会先发一个 dummy transaction 确认 context manager 已经注册好,这就是为什么系统启动早期 getService 会有等待。
这也解释了一个常见现象:系统启动早期 getService 可能返回 null。不是 servicemanager 坏了,是目标服务还没注册。等它注册完,缓存会更新(或者你拿到了 null 但不会再自动重查,取决于调用方式)。
6.3 权限:servicemanager 也要看 SELinux
getService 不只是查表。servicemanager 在返回句柄前,会按服务的 *_service_contexts 配置做 SELinux 检查:发起进程有没有 find 这个服务的权限。addService 同样要检查 add 权限。
这意味着两件在实践中很重要的事:
- 应用进程能拿到哪些系统服务,是策略决定的,不完全是代码决定的。系统应用和普通应用的可见服务集合不同。
- SELinux denial 的日志(
avc: denied { find } for service=...)经常比 Java 异常更早出现。getService返回 null 时,先看 logcat 里的 avc,而不是先怀疑代码。
6.4 三套驱动,三套服务发现
Android 8(Treble)之后,Binder 被拆成三组设备节点,各自配一个 servicemanager:
| 设备 | context manager | 用途 |
|---|---|---|
/dev/binder | servicemanager | framework 服务(AMS、WMS、PMS 等)与普通应用 |
/dev/hwbinder | hwservicemanager | HIDL HAL(正在向 AIDL HAL 迁移) |
/dev/vndbinder | vndservicemanager | vendor 分区内部进程间通信 |
拆分的原因是 vendor 与 system 的边界:Treble 要求 vendor 实现与 system 框架解耦,HAL 的调用不能混在 framework 的服务表里。对应用开发者来说,日常只会碰到 /dev/binder;做 HAL 或系统移植时,才需要区分三者。
另外,Android 13 起 HAL 以 AIDL 为主,HIDL 被标记为弃用(既有实现仍受支持);hwservicemanager 还在,hwbinder 设备节点也还在,新设备上它更多是兼容角色。
6.5 Context.getSystemService 与 ServiceManager 不是一回事
这两个 API 经常被混着讲:
ServiceManager.getService("activity")拿的是原始 Binder 对象,需要自己做asInterface;Context.getSystemService(Context.ACTIVITY_SERVICE)拿的是框架封装好的管理器(ActivityManager),它内部才去ServiceManager查 Binder,再包一层。
应用代码通常用后者;系统代码、需要跨进程拿原生接口的地方用前者。两者失败时的表现也不一样:前者可能返回 null,后者可能抛 RuntimeException 或在第一次调用时失败。
顺带说一个易踩的点:ServiceManager 的静态缓存是进程级单例。如果你在测试里 mock 掉某个服务,或者用 ServiceManager.addService 注入了一个测试服务,缓存可能让另一次测试读到旧对象。写 framework 测试时,清理缓存(反射清 sCache 或使用隔离进程)比反复调试逻辑更有效。
7. 代理与桩:一次调用被拆成两半 链接到此标题
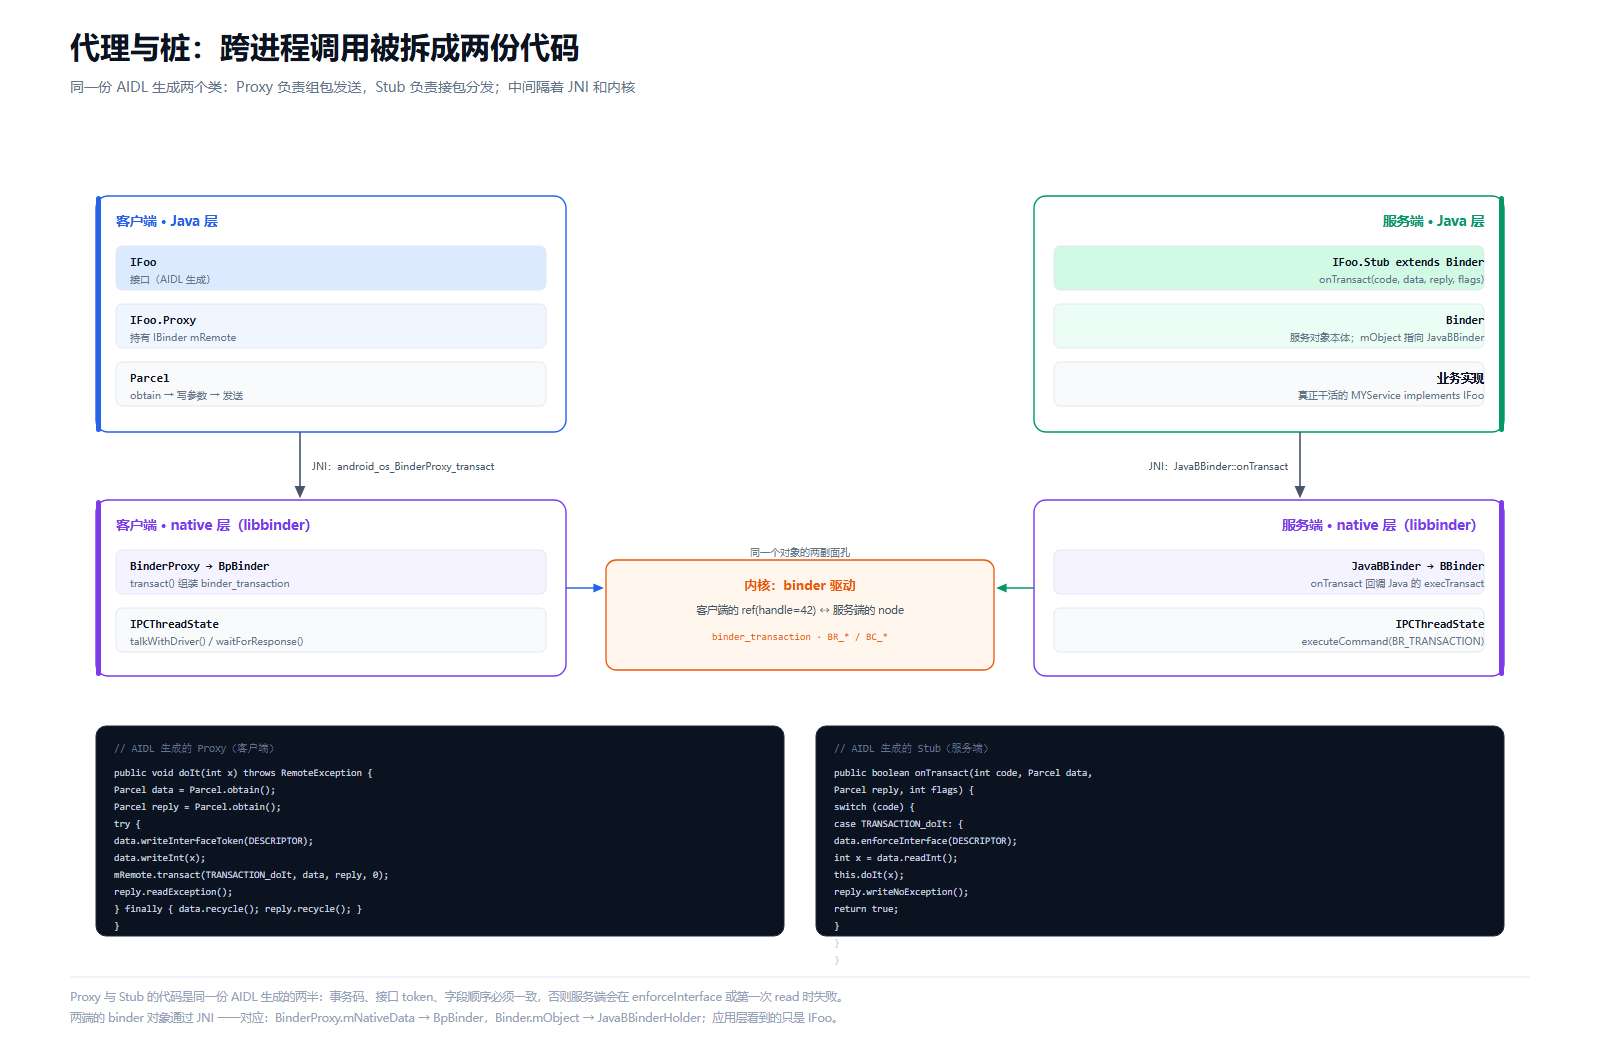
AIDL 是 Binder 体系里最容易被当成“语法糖”的部分。它不只是生成一个接口,而是在客户端和服务端各生成一半实现,两半通过事务码和字节序列对齐。
7.1 生成的两半代码
假设有这样一个 AIDL:
// com/example/IFoo.aidl
package com.example;

interface IFoo {
    int doIt(int x);
    void notifySomething(String s);
}
生成器会产出四样东西(结构如下,细节随 AGP/AIDL 版本略有差异):
IFoo:Java 接口;IFoo.Stub:抽象类,继承android.os.Binder,实现IFoo,核心是onTransact;IFoo.Stub.Proxy:IFoo的代理实现,持有IBinder mRemote,核心是transact;IFoo.Stub.asInterface(IBinder):把IBinder转成IFoo,本地对象直接强转,远端对象包成Proxy。
asInterface 的判断值得多看一眼:
public static IFoo asInterface(android.os.IBinder obj) {
    if (obj == null) return null;
    android.os.IInterface iin = obj.queryLocalInterface(DESCRIPTOR);
    if (iin != null && iin instanceof IFoo) {
        return (IFoo) iin;          // 同一个进程:直接返回本地对象
    }
    return new IFoo.Stub.Proxy(obj); // 跨进程:包一层代理
}
queryLocalInterface 之所以能“认出本地对象”,是因为 Binder 在 attachInterface 里登记了 (DESCRIPTOR → IInterface)。这也是为什么同一个 AIDL 接口在进程内调用时,可以完全不经过 Binder 驱动——它走的是普通的 Java 虚方法调用。
Binder.execTransact 里还有一处和异常语义相关的设计:同步事务中 onTransact 抛出的异常会被写进 reply(客户端 readException() 时重抛);oneway 事务没有 reply,异常只写进日志,调用方永远不知道。这也是 oneway “静默失败” 的另一层来源。
7.2 接口 token 与事务码:两端如何对齐
DESCRIPTOR 是一个字符串(通常是 AIDL 的包名加接口名)。客户端每次调用都先 writeInterfaceToken(DESCRIPTOR),服务端在 onTransact 里用 enforceInterface(DESCRIPTOR) 校验。
这个校验不是形式主义。如果客户端和服务端依赖了不同版本的 AIDL(比如一个库把接口方法加在了前面),事务码会错位;enforceInterface 能挡住“拿旧字节流按新接口解析”这种错误,让失败发生在读第一个参数之前,而不是产生一堆垃圾数据。
事务码本身是 static final int 常量,从 1 开始按 AIDL 里声明的方法顺序分配(IBinder.FIRST_CALL_TRANSACTION = 1)。所以调整 AIDL 方法顺序等于改变协议;要做兼容性演进,只能在末尾追加方法。
7.3 从 transact() 到 BpBinder:JNI 这一跳
BinderProxy.transact 是一个 native 方法:
// android.os.BinderProxy(框架内部类)
public boolean transact(int code, Parcel data, Parcel reply, int flags)
        throws RemoteException {
    ...
    return transactNative(code, data, reply, flags);
}
private static native boolean transactNative(int code, Parcel data,
                                             Parcel reply, int flags)
        throws RemoteException;
对应的 JNI 实现在 frameworks/base/core/jni/android_util_Binder.cpp(这个文件同时管 Binder 与 BinderProxy 两侧的 JNI),它做两件事:把 Java Parcel 转成 native Parcel,调用 BpBinder::transact;如果 native 返回错误,走 signalExceptionForError() 把状态码翻译成 Java 异常。
服务端的对应关系更绕一点:Java 的 Binder 对象在 native 侧有一个 JavaBBinder 作为“外壳”(BBinder 的子类),它持有 Java Binder 的 GlobalRef,并把这个引用挂在自己的生命周期上;Java 侧 Binder.mObject 则指向 JavaBBinderHolder,由它在本进程第一次需要时惰性创建 JavaBBinder。驱动把事务送到服务端后,BBinder::transact 调用 JavaBBinder::onTransact,后者通过 JNI 调到 Java 的 Binder.execTransact,再到 AIDL Stub.onTransact。
这条链上任何一环出问题,现象都很相似(调用失败或超时),但排查入口不同:Java 侧看异常类型,native 侧看 BpBinder 的返回码,内核侧看 BR_FAILED_REPLY 或 BR_DEAD_REPLY。
7.4 Parcel 池与“看起来没关系”的泄漏
Parcel.obtain() 从线程本地的池里取一个实例,recycle() 还回去。池的意义是避免每次调用都重新分配、扩容数据区(Parcel 的缓冲区会随写入增长,反复申请并不便宜)。AIDL 生成的代码都严格配对使用 obtain/recycle,问题通常出在手写 Parcel 的代码里:忘记 recycle(),或者在 recycle() 之后继续用这个 Parcel。
Parcel.recycle() 之后对象仍然可以读,但内容不再保证;如果它在池里被另一次调用复用,你读到的是别人的数据。这类 bug 极难复现,因为要恰好撞上同一个 Parcel 实例。排查时的经验是:任何跨方法传递的 Parcel 都不该由中间层 recycle,谁创建谁回收。
7.5 IBinder 作为参数:对象是如何跨进程的
AIDL 允许把 IBinder 作为参数或返回值。这时 Parcel 里写的是 flat_binder_object,内核按第 5.4 节的方式翻译成 handle;接收方 readStrongBinder() 拿到一个 BinderProxy(或本地对象)。
有一个容易忽略的分支:如果对象“回到老家”(目标进程正是这个 binder 对象的宿主),内核会把它从 BINDER_TYPE_HANDLE 翻回 BINDER_TYPE_BINDER,填回原始的 ptr 和 cookie。此时接收方拿到的是本地对象本身,不是代理:对它调用方法就是一次普通的虚函数调用,不会再过内核。
8. 谁在接电话:线程池与并发语义 链接到此标题
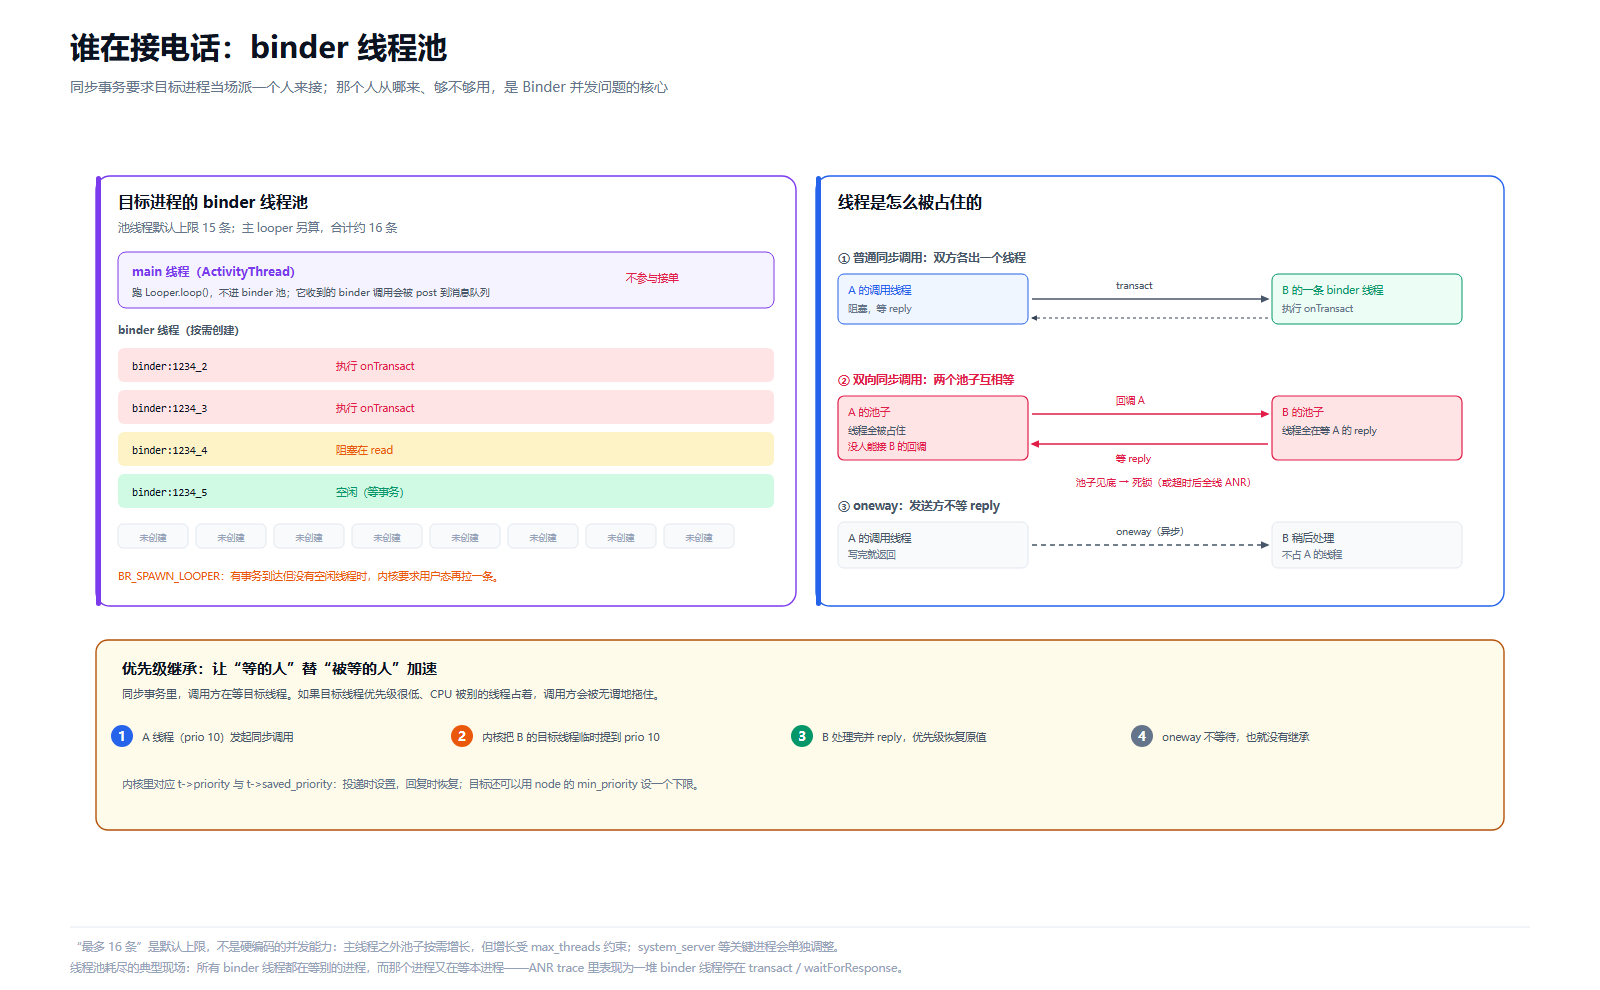
Binder 是同步 RPC:发起方阻塞,服务方必须“当场派人”接。派人的机制,是内核与用户态配合的一套线程池。
8.1 池子从哪来
进程第一次调用 ioctl 时,libbinder 的 ProcessState 会打开驱动、mmap 缓冲区,并设置线程池上限:
// frameworks/native/libs/binder/ProcessState.cpp(简化)
#define DEFAULT_MAX_BINDER_THREADS 15
...
mMaxThreads = DEFAULT_MAX_BINDER_THREADS;
ioctl(mDriverFD, BINDER_SET_MAX_THREADS, &mMaxThreads);
注意这个 15 的含义:它是“池线程”的上限,不含主 looper。池线程不是进程启动时就创建好的,而是被内核“要”出来的:
- 一条 binder 线程在
binder_thread_read里准备睡眠; - 内核判断“现在没有空闲线程接活、也没在别处要线程、池子没满”,就在这次读操作里塞一条
BR_SPAWN_LOOPER; - libbinder 收到这条命令,新建一个线程并让它跑
IPCThreadState::joinThreadPool; - 新线程的第一条命令是
BC_REGISTER_LOOPER,向内核报到。
这四个条件(简化表述)是:已请求但未到岗的线程数为 0、没有线程在 proc 级等待、已启动池线程数小于上限、当前线程自己是一个 looper。少一个都不触发。
主动 looper 线程走的是另一条路:BC_ENTER_LOOPER,它声明“我要收事务”,但不占池子的名额。很多进程里这条线程是 ProcessState::startThreadPool() 拉起来的,而不是 main 线程本身;servicemanager 这类进程则可能让 main 线程直接 joinThreadPool。所以一个进程的 binder 线程数大致是 1(主动 looper)+ 最多 15(池线程)。
池线程还有一个容易被忽略的性质:拉起之后不会回收。libbinder 没有“空闲时退线程”的逻辑,一个进程经历过一次并发高峰,线程数就会停在峰值上。debugfs 里的 ready threads 是当前空闲线程数,它掉到 0 就意味着下一个事务要排队了。
8.2 主线程不接单,但也不是完全无关
应用进程的主线程(ActivityThread)通常不在 binder 线程池里:它跑 Looper.loop(),处理消息队列。系统发来的生命周期事务(LaunchActivityItem、ResumeActivityItem 等)是由 binder 线程接住,再 post 到主线程的消息队列执行的。
这个设计带来两个后果:
- 服务端的
onTransact跑在 binder 线程上,不能直接碰 View、也不能假设自己在主线程。这些线程没有Looper.prepare(),所以连Handler都不能直接建;所有需要主线程的工作,得拿主线程的Handler去 post。 - 主线程如果阻塞在一次同步 binder 调用里,它同时也阻塞了自己的消息队列:系统发来的生命周期、输入事件、
Choreographer回调全都会排队。这就是“主线程做 IPC”最危险的地方——不是那次调用慢,而是它把整个 UI 线程的消息循环按住了。
8.3 线程池耗尽与嵌套调用
线程池耗尽的经典形态是双向同步调用:A 调用 B,B 在 onTransact 里又同步回调 A。如果 A 的线程池已经被占满(所有线程都在等 B),B 的回调就没有线程能接,双方互相等。
内核对此有一层保护:binder_transaction 会检查目标进程是否已经在当前调用链上(is_nested);如果是,它会复用调用链上的线程,而不是从池里另挑一个。这样可以避免“调用链绕回来时自己等自己”的必然死锁。
但这层保护只覆盖“同一调用链”这一种情况。更复杂的场景(多条调用链交叉、池子被别的业务占满、主线程自身阻塞)仍然会死锁或长时间排队。工程上的经验规则:
- 永远不要在 binder 线程上做慢操作(文件 IO、数据库、网络、等锁);
- 跨进程回调要设计成
oneway(如果不需要返回值),或者至少给调用设超时; - 不要在持有锁的时候发起同步 IPC——锁顺序反转是线程池耗尽的常见诱因;
- 关键服务的线程池上限要单独评估,15 是默认值,不是“够用”的承诺。
8.4 oneway 的三条硬语义
oneway 不是“丢到后台随便跑”,内核给了它三条明确语义(第 5.8 节提过,这里展开):
- 按 node 串行:同一个
binder_node上,同一时刻只允许一个 oneway 事务处于“已投递未释放”状态,后面的事务排队。这保证了 oneway 调用的先后顺序,但也意味着接收方处理慢会直接卡住发送方(buffer 分配不到)。 - 有独立配额:oneway 事务只能用接收方 mmap 区的一半左右(内核里
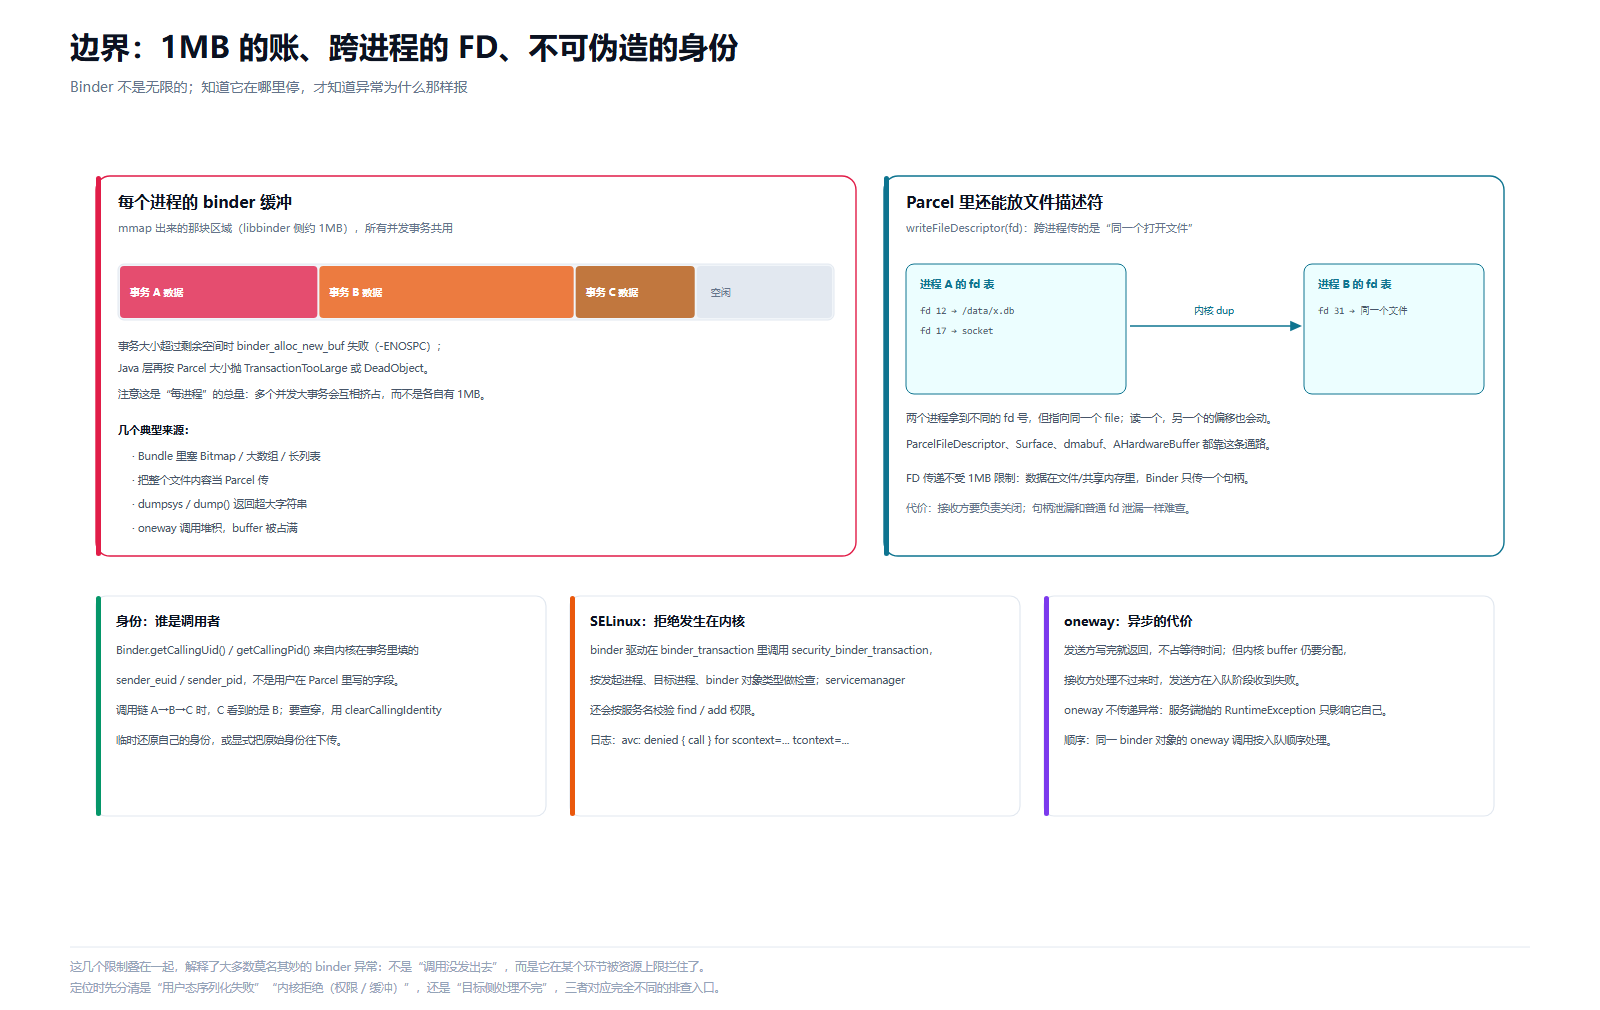
free_async_space = buffer_size / 2),超了返回-ENOSPC,用户态表现为BR_FAILED_REPLY。内核还会在剩余异步空间低于总量 10% 时给后来的事务打上oneway_spam_suspect标记,libbinder 读到BR_ONEWAY_SPAM_SUSPECT会打印 “Process seems to be sending too many oneway calls.” 和调用栈。所以 oneway 洪泛不会无限堆积,但会在配额处失败,而且失败前会有告警。 - 不继承优先级:同步事务会把发送线程的调度优先级临时“搬”到目标线程上(第 8.5 节),oneway 不会——它用目标进程的默认优先级。
失败语义也要说清楚:oneway 的发送方在入队阶段能收到错误(目标死亡、被冻结、buffer 不够),一旦成功入队,之后目标进程死掉,发送方不会收到任何通知。事务可能被丢弃,接收方最多收到一条 BR_ONEWAY_SPAM_SUSPECT 作为用量告警。
8.5 优先级继承:让“等的人”替“被等的人”加速
同步事务里,调用方在等目标线程。如果目标线程优先级很低、CPU 被别的线程占着,调用方会被无谓地拖住。Binder 的做法是:在投递事务时,把发送方(或调用链上更高的)调度策略临时应用到目标线程上。
官方文档把 Binder 的优先级继承分成三种,这个分类比“一个继承”清楚得多:
- 事务优先级继承:同步事务把调用方线程当前的
policy和normal_prio带给目标线程;发送方如果是SCHED_IDLE之类的特殊调度类,就不继承。 - 节点优先级继承:服务端可以通过
BBinder::setMinSchedulerPolicy()给自己的接口设一个优先级下限,实际生效值是max(节点下限, 调用方优先级)。作用是“这个接口再怎么样也不能比某个优先级低”。 - 实时优先级继承:
BBinder::setInheritRt(true)才允许调用方的实时优先级传进来,默认关闭——RT 优先级一旦乱传,会把整机调度搞乱。
内核侧的细节:事务里保存 saved_priority,回复时恢复;节点上还有 FLAT_BINDER_FLAG_PRIORITY_MASK、FLAT_BINDER_FLAG_INHERIT_RT 控制服务端愿意接受什么。oneway 不参与继承。
这套机制在 Android 14 的内核里做过一次细化:binder_thread 增加了 prio_lock 和 prio_state,处理“线程正在被改优先级时又收到嵌套事务”的竞态——老代码在这种窗口里保存的 saved_priority 可能是中间态,恢复之后优先级就错了。
8.6 冻结:被缓存的应用也要“能回话”
Android 的 cached app freezer 会冻结后台进程。一个被冻结的进程收到同步事务怎么办?让它慢慢解冻会拖死调用方,直接当死掉处理又会误伤。
内核的做法是返回 BR_FROZEN_REPLY(以及后续版本的 BR_TRANSACTION_PENDING_FROZEN),让调用方立刻知道“对方现在不可用”,而不是无限期等待。同时,冻结进程的异步队列会特殊处理:同一个 node 上同 code 的旧 oneway 事务可以被新事务顶替(TF_UPDATE_TXN),避免解冻时处理一堆已经过期的请求。
Android 14 之后还有一层更硬的后果:CachedAppOptimizer 检测到冻结进程收到同步事务时,会直接把它 kill 掉(日志 “received sync transactions while frozen, killing”)。也就是说,调一个被冻结的进程,代价可能是它被杀。与之相对,oneway 事务不会立刻失败,会缓冲到解冻后处理——但异步空间塞满时,接收方也可能出问题。
这一节的内容在应用层很少直接碰到,但在做系统性能分析时会看到:一个 binder 调用突然返回 Frozen,不是 bug,是冻结框架在按预期工作。
9. 对象活多久:引用计数与死亡通知 链接到此标题
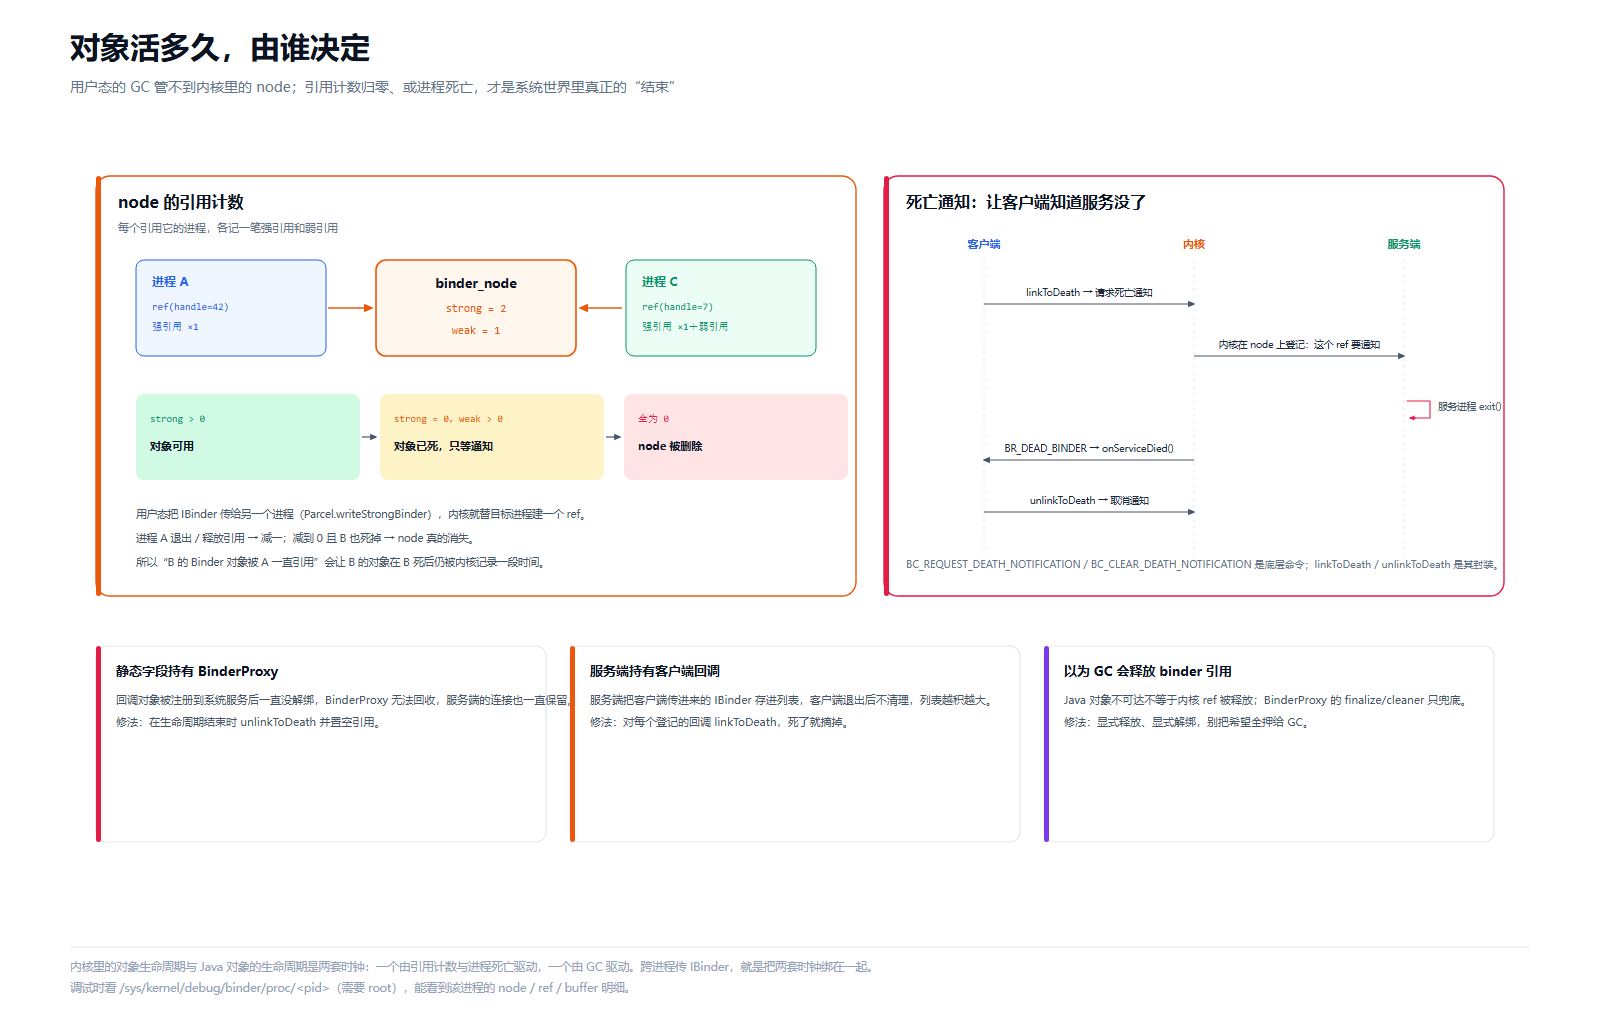
Java 有 GC,Binder 没有。内核里的 node 什么时候消失、客户端的 DeathRecipient 什么时候被调用,是另一套规则。
9.1 node 的存活由四类计数决定
简单说“引用计数归零就删”并不准确。内核里 binder_node 的存活至少涉及:
| 计数 | 谁加减 | 含义 |
|---|---|---|
internal_strong_refs | 驱动内部 | “有 ref 指向我”这件事本身的隐式强引用 |
local_strong_refs | 用户态 BC_ACQUIRE/BC_RELEASE | 用户态声明的强引用 |
local_weak_refs | 用户态 BC_INCREFS/BC_DECREFS | 用户态声明的弱引用 |
tmp_refs | 驱动内部临时引用 | 保证加锁/翻译过程中不被释放 |
用户态的 linkToDeath、Parcel.writeStrongBinder、BC_ACQUIRE 最终都会反映到这些计数上。它们的组合决定了 node 是“活着”、“已死但还被记着”还是“可以释放”。
9.2 死亡与释放是两件事
服务进程退出时,驱动不会立刻删掉所有 node,因为别的进程还持有 ref。它做的是:
- 把每个 node 标记为 dead(
node->proc = NULL),挂进全局的binder_dead_nodes; - 对每个注册过死亡通知的 ref,投一条
BINDER_WORK_DEAD_BINDER,唤醒持有者; - 等最后一个 ref 也消失、临时引用归零,才真正
kfree。
这就解释了为什么“服务死了之后,客户端还能拿着 BinderProxy 调几次”——前几次调用会失败(DeadObjectException),但对象本身还在,直到引用清理完。也解释了为什么“泄漏一个 BinderProxy 会拖住服务端的 node”——node 因为还有 ref 而不能释放,即使宿主进程已经死了。
9.3 死亡通知的完整协议
Java 层的 linkToDeath 只是封装,底层是三条命令:
客户端 → 内核:BC_REQUEST_DEATH_NOTIFICATION { handle, cookie }
服务端进程死:驱动把 BINDER_WORK_DEAD_BINDER 投到客户端的 todo
客户端 ← 内核:BR_DEAD_BINDER { cookie }
客户端 → 内核:BC_DEAD_BINDER_DONE { cookie } // 确认处理完撤销通知是另一条路径:BC_CLEAR_DEATH_NOTIFICATION → BR_CLEAR_DEATH_NOTIFICATION_DONE。这里有一个细节设计:如果撤销时已经有一条 BR_DEAD_BINDER 在飞,驱动会把状态标成 DEAD_BINDER_AND_CLEAR,保证 BR_DEAD_BINDER 仍然先送达,不会出现“通知被吞掉”的竞态。
BC_DEAD_BINDER_DONE 很容易被忽略。它不是可选的礼貌应答,而是驱动回收 binder_ref_death 结构的前提;用户态如果一直不确认,那个 death 结构就一直挂着。
还有一个用户态的限制:linkToDeath 只在跨进程的 Binder 上真正注册。同一个进程内的 Binder 对象,linkToDeath 不会产生任何驱动层效果,binderDied 也永远不会被调用——因为根本没有“对面进程死亡”这件事。写单元测试时要模拟 binderDied,得用 mock 或真的起两个进程。
Android 15 还改了一处细节:targetSdk ≥ 35 的应用,JavaDeathRecipient 对 Java 对象改用弱引用,避免死亡回调本身成为内存泄漏的根。对普通业务代码没有影响,但如果你的代码依赖“注册了 death recipient 就等于强引用住对象”,在 targetSdk 35 之后会变。
9.4 三种典型泄漏
静态字段持有 BinderProxy。 回调对象被注册到系统服务后一直没解绑,BinderProxy 无法回收,服务端的 node 也一直有 ref。修法:在生命周期结束时 unlinkToDeath 并置空引用。
服务端持有客户端回调。 服务端把客户端传进来的 IBinder 存进列表,客户端退出后不清理。修法:对每个登记的回调 linkToDeath,收到通知就摘掉。
以为 GC 会释放 binder 引用。 Java 对象不可达不等于内核 ref 被释放。BinderProxy 的 finalizer / cleaner 只是兜底,不保证及时,也不保证在你期望的线程上运行。修法:显式解绑、显式释放,别把希望全押给 GC。
另外,官方 IBinder 文档明确写了:在 binderDied 回调里不需要再 unlinkToDeath——对象已经死了,proxy 的最后一个本地引用释放时会自动解链。真正需要 unlinkToDeath 的是“对象还活着,但我不想再收通知”的场景,比如 onDestroy 里主动撤销。至于回调注册本身,推荐用 RemoteCallbackList,它已经处理了死亡解绑与并发。
9.5 进程退出时驱动做了什么
close(/dev/binder) 时,驱动的 binder_release 只做三件事:删调试入口、删 binderfs 入口、把一个释放任务丢进 workqueue。真正的清理(摘 proc 链表、释放线程、释放 node、清理 ref 和事务、归还页)在 workqueue 里完成。
这么做是因为 release 的上下文里锁状态复杂,直接清理容易死锁。延迟期间,对该进程 fd 的任何新 ioctl 都会返回 ECONNREFUSED。所以“进程正在退出”这个状态,从 Binder 的角度看是可见的,而且会持续一小段时间。
10. 边界:1MB 的账、跨进程的 FD、不可伪造的身份 链接到此标题
Binder 不是无限的。它的限制大多来自内核,而不是 Java 层;知道限制在哪,才知道异常为什么那样报。
10.1 那块 mmap 区:每进程约 1MB
libbinder 在打开驱动时 mmap 一块区域,大小是:
// frameworks/native/libs/binder/ProcessState.cpp
#define BINDER_VM_SIZE ((1 * 1024 * 1024) - sysconf(_SC_PAGE_SIZE) * 2)
也就是 1MB 减去两页(4KB 页时约 1,040,384 字节)。内核侧还会再截一次上限:alloc->buffer_size = min_t(unsigned long, vma_size, SZ_4M),用户态 mmap 再大也只认 4MB。
这块区域是所有并发事务共享的:一次 200KB 的事务、一次 300KB 的事务、一次 100KB 的事务同时在飞,就从同一块区域里切。切不出来时,binder_alloc_new_buf 返回 -ENOSPC,驱动把它映射成 BR_FAILED_REPLY。
Java 侧其实还有一个“提醒”机制:Binder.checkParcel 在 Parcel 超过 800KB 时会打一条 Log.wtf 告警(受 CHECK_PARCEL_SIZE 开关控制),但它不抛异常。这条日志的意义是“你快要撞墙了”,而不是“你已经超限了”。很多人把它当成限制本身,其实真正的失败发生在内核分配 buffer 的那一刻。
这里是最容易误解的一点:TransactionTooLargeException 不是“Parcel 超过 1MB 就抛”,而是“这次事务失败(内核返回 BR_FAILED_REPLY),并且 JNI 按请求 Parcel 大小判断‘很可能是尺寸问题’”。判断逻辑就在 signalExceptionForError() 里:
case FAILED_TRANSACTION: {
    ALOGE("!!! FAILED BINDER TRANSACTION !!!  (parcel size = %d)", parcelSize);
    if (canThrowRemoteException && parcelSize > 200 * 1024) {
        // bona fide large payload
        exceptionToThrow = "android/os/TransactionTooLargeException";
        msg = ... "data parcel size %d bytes";
    } else {
        // Heuristic: a payload smaller than this threshold "shouldn't" be too
        // big, so it's probably some other, more subtle problem. In practice
        // it seems to always mean that the remote process died while the binder
        // transaction was already in flight.
        exceptionToThrow = "android/os/DeadObjectException";  // 或 RuntimeException
        msg = "Transaction failed on small parcel; remote process probably died, "
              "but this could also be caused by running out of binder buffer space";
    }
    jniThrowException(env, exceptionToThrow, msg.c_str());
} break;
所以同一个内核失败,在 Java 层可能表现为三种异常之一:
- 请求 Parcel 大于 200KB →
TransactionTooLargeException; - 请求 Parcel 不大 →
DeadObjectException(message 里那句 “running out of binder buffer space” 就是线索); - 调用点不允许抛受检异常 →
RuntimeException。
这也意味着:没到 1MB 也可能收到 TransactionTooLargeException(200KB 到 1MB 之间,加上并发挤占),而小于 200KB 的 buffer 失败反而会伪装成“目标进程死了”。看到 TransactionTooLargeException,先看 Parcel 大小、再看目标进程当时的缓冲占用;看到 “Transaction failed on small parcel”,先别急着认为对端崩溃,也可能是它没缓冲了。
oneway 还有自己的配额:内核把 free_async_space 初始化为映射大小的一半左右。同步事务和 oneway 事务共用同一块区域,但 oneway 的可用空间只有其中的一半。
10.2 大对象:不要塞进 Parcel
Binder 事务的合理尺寸是“控制信息 + 小数据”,不是“文件内容”。大块数据有专门的通路:
- 文件描述符:
Parcel.writeFileDescriptor。内核在事务里先记下这个 fd 对应的struct file(记进事务的fd_fixups),等目标线程真正读事务时才在目标进程里安装一个新的 fd(效果相当于dup)。两个 fd 指向同一个打开文件(共享偏移)。数据本身留在文件/设备里,不进 binder buffer。 - 共享内存:
SharedMemory(ashmem / memfd)、AHardwareBuffer、Surface。传的是句柄,数据在内核/显存里共享。 - 匿名管道:适合流式数据,配合 fd 传递。
FD 的语义值得单独说:跨进程传 fd 之后,两个进程拿到的是不同的 fd 号,但同一个 struct file。读一个,另一个的偏移也会动。接收方要负责关闭自己那份;忘了关,就是普通 fd 泄漏,只是更难发现——因为它看起来像是“对方没关”。
10.3 身份:sender_euid 为什么可信
Binder 事务里带着 sender_pid 和 sender_euid,这两个值由内核在 binder_transaction 里从当前 task 结构直接填,不来自用户态。服务端 Binder.getCallingUid() 拿到的是它们,所以:
- 调用者不能通过构造 Parcel 伪造自己的 uid;
- 但这也意味着服务端看到的永远是直接调用方。A 调 B、B 调 C 时,C 看到的是 B 的 uid,不是 A 的。
- 需要“穿透”身份时,要么由 B 显式把原始身份传下去,要么用
Binder.clearCallingIdentity()/restoreCallingIdentity()临时切换。后者的语义是“以本进程的身份执行”,用完必须恢复,否则后续调用都会以错误的身份发出。
SELinux 还会检查一个额外权限:如果发起线程的当前 sid 与进程 cred 的 sid 不一致(比如进程 setuid 之后复用旧的 binder fd),驱动会要求 binder { impersonate }。这就是“借别人的身份发 binder 调用”在内核层的拦截点。
10.4 SELinux:拒绝发生在两处
Binder 相关的 SELinux 检查分布在两处,各自负责不同的问题:
第一处:内核驱动,4 个权限。
| 权限 | 检查时机 |
|---|---|
binder { call } | 每次跨进程事务(security_binder_transaction) |
binder { transfer } | 传递 binder 对象本身(binder_transfer_binder) |
binder { set_context_mgr } | 设置 context manager(set_context_mgr) |
binder { impersonate } | 当前 sid 与进程 cred 的 sid 不一致时(impersonate) |
第二处:servicemanager 用户态,按服务名校验。 它先用 selabel_lookup 在 *_service_contexts 里查到服务名对应的 SELinux 上下文,再用 selinux_check_access 检查调用者有没有 service_manager { find } 或 { add } 权限。查不到服务名对应的上下文,直接拒绝。
对开发者来说,这两处的日志形态不同:内核拒绝通常表现为 avc: denied { call },服务名拒绝表现为 avc: denied { find } for service=... 或 getService 返回 null。看到 getService 拿到 null,先 grep avc,比在代码里找半天更快。
Binder 还提供了 TF_CLEAR_BUF / IBinder.FLAG_CLEAR_BUF:带上这个 flag 的事务在完成后会把 buffer 清零,防止密码、token 这类敏感数据留在内核缓冲里。代价是释放时多一次 memset,所以只对确实敏感的接口开,不要全局开。
10.5 设备节点与 binderfs
/dev/binder 不是唯一入口。内核里 binder 是单模块、多设备节点:CONFIG_ANDROID_BINDER_DEVICES 默认是 "binder,hwbinder,vndbinder",每个节点各自有一份 binder_context(自己的 context manager、自己的 node / ref 命名空间),互不干扰。注意这是旧路径:编译期开了 CONFIG_ANDROID_BINDERFS 之后,binder.devices 参数会被整段跳过,设备改由 binderfs 动态创建。
Android 11 起,init.rc 挂载 binderfs 并 symlink 出上述三个设备节点:
# init.rc(Android 11+),注意挂载时写的文件系统类型是 binder,不是 binderfs
mount binder binder /dev/binderfs stats=global
binderfs 的好处是:设备节点可以按需动态创建、按 mount namespace 隔离,适合容器和虚拟化场景;同时它提供了一份 binder_logs/ 镜像,把 debugfs 里的统计文件搬到不需要 root 的位置(/dev/binderfs/binder_logs/)。三套设备节点各自有独立的 binder_context,node / ref 空间完全隔离,因此一个域里的 handle 拿到另一个域里没有意义。
binderfs 还有个 features/ 目录,暴露内核支持的能力位:oneway_spam_detection、extended_error、freeze_notification 等。libbinder 启动时会读这些文件,决定是否启用对应的用户态特性。
10.6 oneway 洪泛检测
oneway 调用可以大量堆积,而且不占调用方的等待时间,很容易被用来做高频通知。内核为此加了检测:当同一 node 上 oneway 的使用量超过阈值时,驱动会给接收方发 BR_ONEWAY_SPAM_SUSPECT,用户态可以把这种模式记进日志、在性能分析时当成可疑信号。
这个机制默认不一定开启,检测阈值也不公开承诺。但它说明了一件事:oneway 不是免流控的后门,它只是把背压从“调用方等待”换成了“buffer 配额”。
11. 时间花在哪:把一次调用拆成六段 链接到此标题
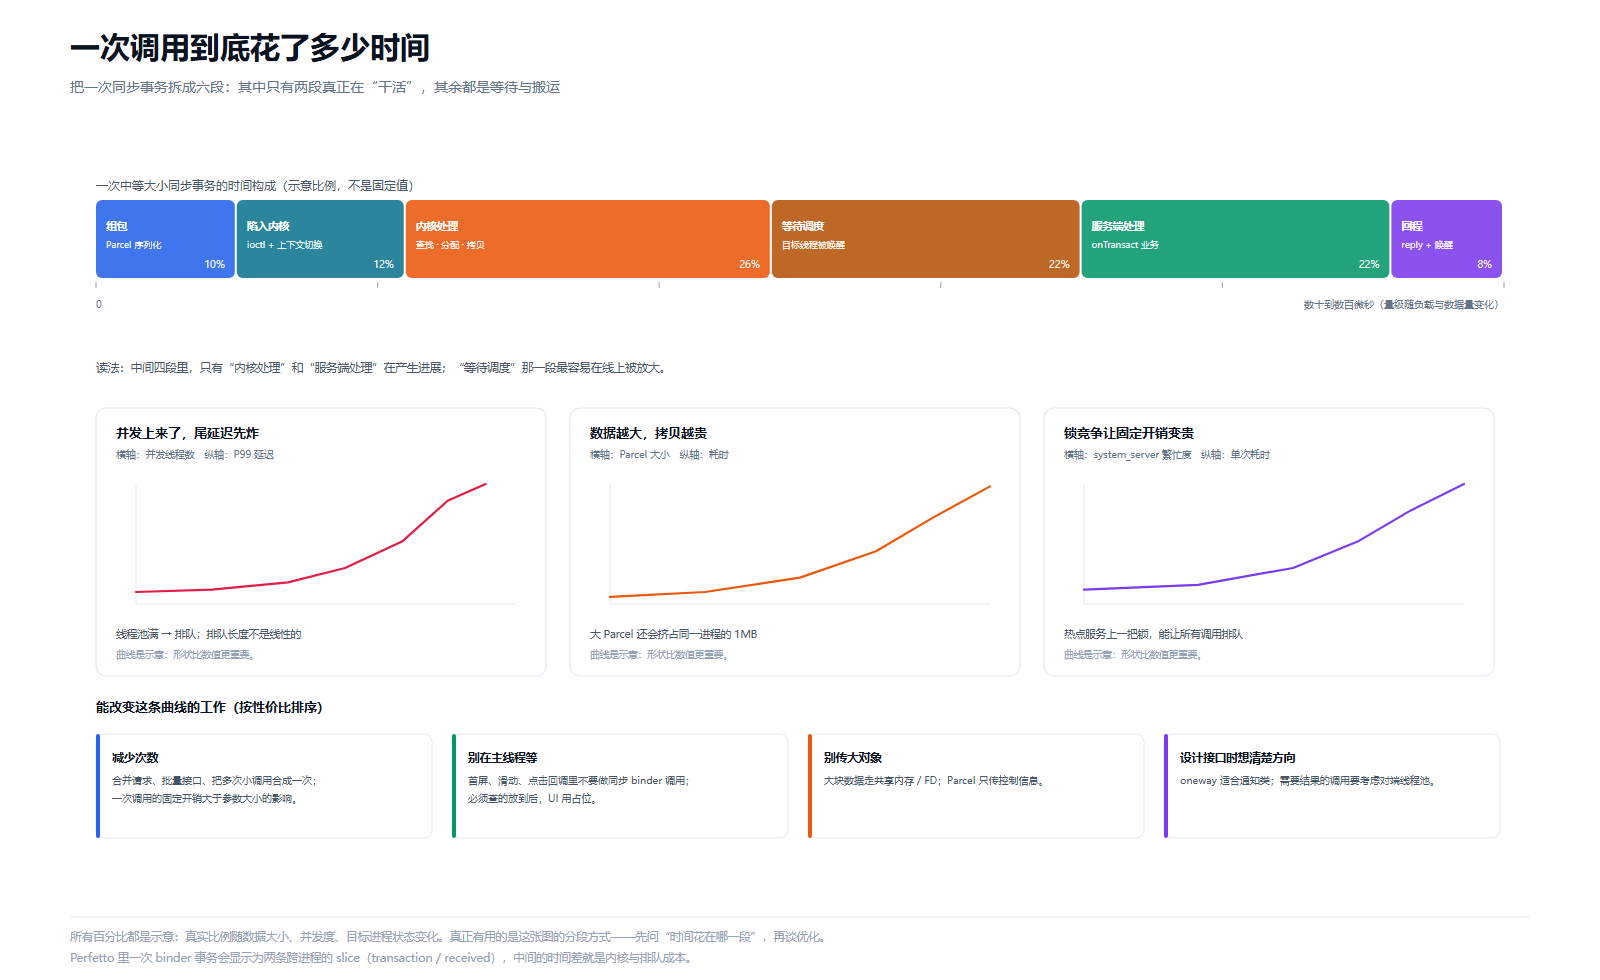
到这里,链路的每一段都清楚了。把它们放回时间轴上,能看到一个反直觉的结论:真正在处理业务的时间,往往只占一小部分。
11.1 六段分解
一次中等大小的同步事务,大致可以拆成:
| 段 | 内容 | 受什么影响 |
|---|---|---|
| 组包 | Parcel 序列化、写接口 token、分配 | 数据大小、对象数量、Java 层装箱 |
| 陷入内核 | ioctl、上下文切换、驱动解析命令 | 系统调用开销、CPU 频率、安全补丁 |
| 内核处理 | 查 node/ref、分配 buffer、copy_from_user、翻译 offsets、入队 | 数据大小、并发事务数、锁竞争 |
| 等待调度 | 目标线程被唤醒、等 CPU | 系统负载、目标线程优先级、PI 是否生效 |
| 服务端处理 | onTransact 业务、可能再发起下游调用 | 业务逻辑、下游延迟 |
| 回程 | BC_REPLY、唤醒发起线程 | 同上 |
对一条“空调用”(只传一个 int、服务端立刻返回)来说,固定开销在几十微秒量级;对一条携带几十 KB 数据、目标进程繁忙的调用来说,容易涨到毫秒级。一个公开可查的量级是 LKML 上 binderThroughputTest 的实测:单次同步事务几十微秒、P99 约 0.1 ms(特定内核与机器,非 Android 官方口径)。这些数字随设备、内核、负载变化很大,不要拿别人的绝对值当基准,要看比例和趋势。
11.2 尾延迟:并发上来之后先炸的是 P99
单次调用的平均值没什么意义,因为 Binder 的瓶颈几乎都是排队型瓶颈:
- 线程池满:事务在
proc->todo里排队,等一条线程空闲; - 锁竞争:system_server 里某把锁被持有,所有相关服务的调用一起排队;
- oneway 配额满:发送方在入队阶段直接失败(
-ENOSPC→BR_FAILED_REPLY); - 目标进程被冻结:同步调用快速失败,但重试逻辑可能把请求量放大。
这些现象在平均值上看不出来,在 P99 上非常明显。线上做 Binder 性能分析,先看“调用量 × 并发度”与“P99 延迟”的关系,比看均值有用得多。
11.3 大 Parcel 的代价不是线性的
copy_from_user 的开销随数据量线性增长,但一个大数据事务还会带来额外成本:
- 它占用的 buffer 会挤占同一进程的其他事务,导致它们分配失败或等待;
- 跨页拷贝会触发
kmap,页的安装与回收也可能进入慢路径; - offsets 里对象越多,内核翻译循环越长;
- 接收方一次读不完(分批读),或者读完之后
Parcel里的数据又触发一次 Java 层拷贝。
所以“把数据合并成一次大调用”并不是永远正确。经验上,合并到几百 KB 以内通常是赚的;再大,就该考虑共享内存了。
11.4 锁竞争:system_server 为什么“越忙越慢”
framework 里最热的几个服务(AMS、WMS、PMS)都在 system_server 里,而 system_server 处理 binder 事务用的是自己的线程池。它同时还要跑大量内部任务,持有各种全局锁。
当某个服务持锁做慢操作(扫包、解析配置、等 IO),其他线程的 binder 事务就会在锁上排队。此时从客户端看,延迟涨了,但 trace 里看不到“你的代码慢”——时间花在等锁。这也是为什么系统侧的优化经常是“缩小锁粒度”“把工作挪出锁外”“减少持锁 IPC”。
11.5 能改变这条曲线的工作
按性价比排序,实际项目里最有效的通常是这几类:
- 减少调用次数:合并请求、批量接口、把循环里的逐条调用改成一次批量调用。固定开销远大于参数大小带来的影响。
- 别在主线程等:首屏、滑动、点击回调里不做同步 IPC;必须查的放后台,UI 用占位内容。
- 别传大对象:大块数据走共享内存或 FD,Parcel 只传控制信息。
- 设计接口时想清楚方向:通知类用 oneway;需要结果的调用要评估对端线程池;回调接口必须有死亡处理。
- 审视线程池配置:关键系统服务、长耗时服务端,需要单独评估线程池上限与超时。
- 别乱用优先级:PI 是为了解决等待,不是给业务提速;滥用实时优先级会让调度更糟。
12. 怎么看见一条看不见的调用 链接到此标题
Binder 的调试难点在于:它横跨用户态和内核态,单看一侧都看不到全貌。四个入口各回答一个问题。
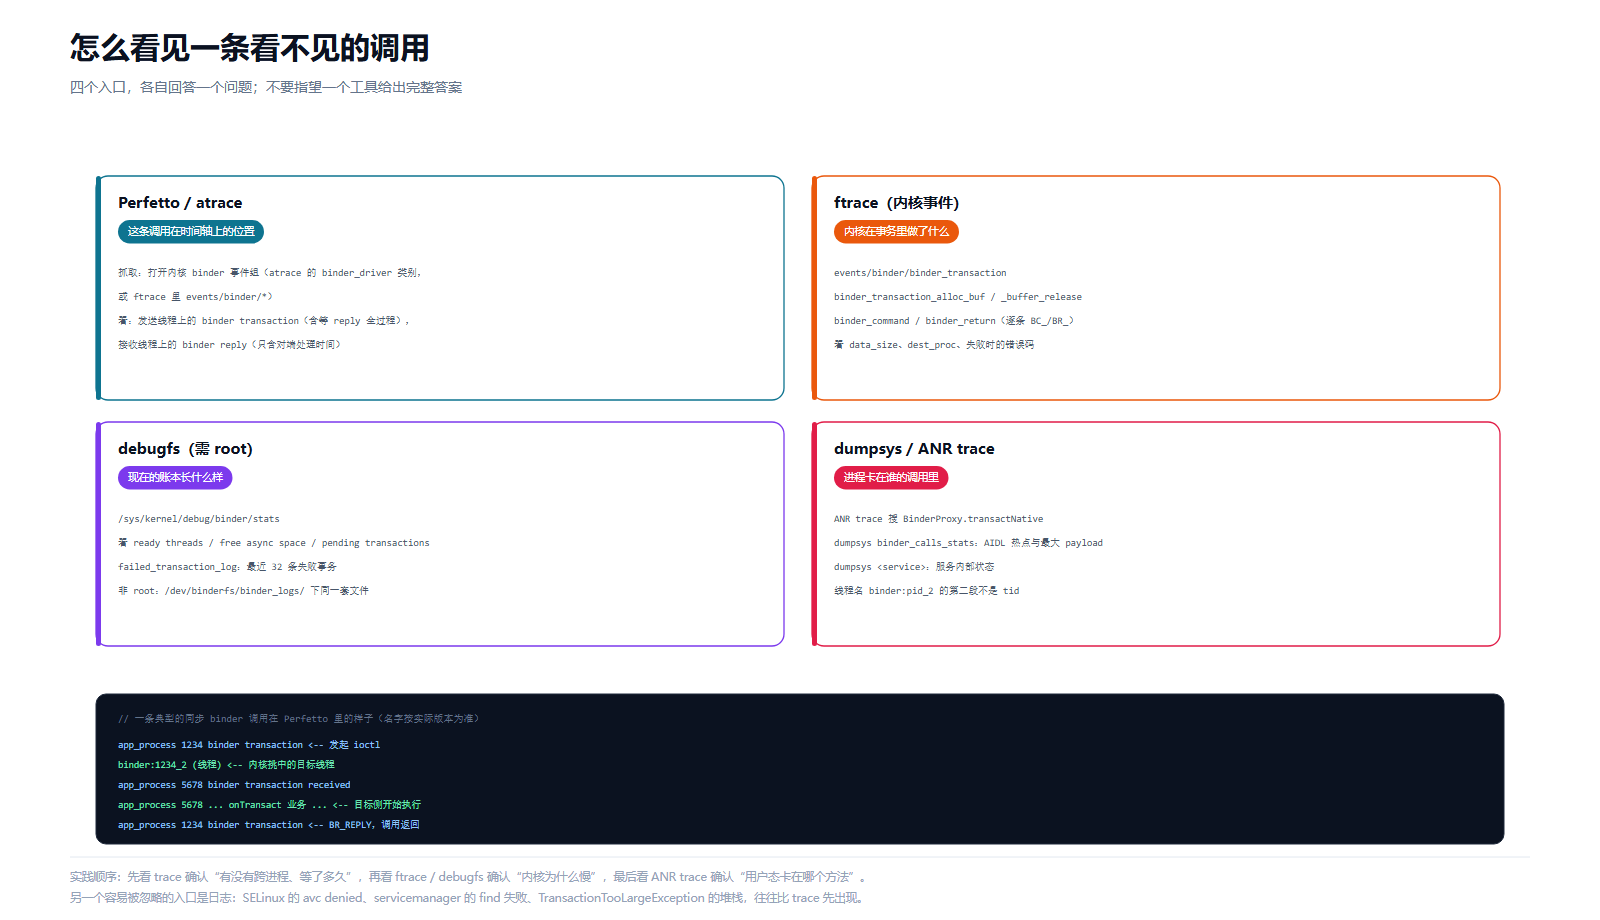
12.1 Perfetto:看时间轴上的位置
Perfetto 里能看到的 binder transaction、binder reply、binder transaction async、binder async rcv 这几类 slice,不是 libbinder 主动打的 atrace,而是 trace_processor 从内核 ftrace 事件合成出来的。它消费的是 binder/binder_transaction 与 binder_transaction_received 两组 tracepoint,合成规则很具体:
- 发送线程上:同步调用是一条
binder transactionslice,从发出一直持续到收到 reply(包含对端处理的全部时间);oneway 是瞬时事件binder transaction async。 - 接收 / 回复线程上:同步调用是一条
binder replyslice,从收到事务到把 reply 发回去;oneway 接收侧是瞬时事件binder async rcv。 - 两条 slice 之间有 flow 箭头,可以跨进程追一条调用链;slice 参数里带 transaction id、destination node/proc/thread、flags、code、data size、offsets size。
这对抓取方式有直接影响:这些 slice 的数据来源是内核的 binder tracepoint,所以抓取时必须打开内核 binder 事件组——atrace 里对应 binder_driver 类别(它会启用 binder_transaction、binder_transaction_received、binder_transaction_alloc_buf 三个事件),或者直接在 Perfetto 配置里写 ftrace_events: "binder/binder_transaction" 等。
顺带澄清两个流传很广的误解:
binder_lock/binder_locked/binder_unlock这组 tracepoint 已被移除(Perfetto 源码注释说 v4.14 起 obsolete),现代设备上binder_lockatrace 类别抓不到数据;- 内核里没有
binder_alloc_buf/binder_free_buf这两个事件名,对应的是binder_transaction_alloc_buf与binder_transaction_buffer_release。
读 trace 时看三个东西:
- 跨进程箭头的位置:调用从哪个线程发出、落在哪个线程上;
- 两条 slice 的差:发送侧时长减去接收侧时长,就是排队、调度与内核搬运的成本;
- 同一时间窗内的事务数量:一条线程上出现大量重叠的 binder 事务,说明它在并发处理,线程池可能吃紧。
如果只是想知道“哪个 AIDL 方法最贵”,可以不用手写 SQL:Perfetto 有现成的 android_binder metric(AndroidBinderMetric),按进程聚合事务数量与耗时,字段里有 aidl_name、is_main_thread、client_dur、server_dur、thread_states、blocked_functions。做线上或本地性能分析时,它比一条条看 slice 高效得多。
12.2 ftrace:看内核在事务里做了什么
内核的 binder tracepoint 一共十几条,常用的有:
| 事件 | 看什么 |
|---|---|
binder_transaction | 每次事务投递:transaction id、dest node/proc/thread、reply 标志、code、flags |
binder_transaction_received | 目标线程收到事务 |
binder_transaction_alloc_buf | buffer 分配:data_size、offsets_size、extra_buffers_size |
binder_transaction_buffer_release | buffer 释放(注意名字,不是 free_buf) |
binder_transaction_node_to_ref / ref_to_node | 对象翻译方向 |
binder_transaction_fd_send / _fd_recv | FD 传递 |
binder_command / binder_return | 逐条 BC_* / BR_*,事务终止在哪个命令一目了然 |
binder_set_priority | 优先级继承:旧值、新值、期望值 |
binder_update_page_range | 装页/回收页(大 Parcel 的额外成本) |
binder_wait_for_work | 线程为什么睡眠:proc 级工作、事务栈、线程队列 |
打开方式(需要 root,路径随内核版本略有差异):
adb shell "echo 1 > /sys/kernel/tracing/events/binder/enable"
adb shell "cat /sys/kernel/tracing/trace_pipe"
ftrace 适合回答“这条事务到底有没有到内核”“它被翻译成了哪个 handle”“为什么没被投递”。它不适合看用户态方法级的耗时,那要用 Perfetto 或 systrace。
12.3 debugfs 与 binderfs 镜像:看当前账本
内核在 debugfs 里暴露了 binder 的运行时状态(需要 root):
/sys/kernel/debug/binder/state            # proc / thread / node / ref 的完整快照
/sys/kernel/debug/binder/state_hashed     # 同上,指针做脱敏
/sys/kernel/debug/binder/stats            # 全局计数器 + 每个进程一段统计
/sys/kernel/debug/binder/transactions     # 正在处理的事务列表
/sys/kernel/debug/binder/transaction_log        # 最近 32 条事务的环形记录
/sys/kernel/debug/binder/failed_transaction_log # 最近 32 条失败事务
/sys/kernel/debug/binder/proc/<pid>       # 单个进程的 node / ref / buffer 明细
Android 11 之后还有一个不需要 root 的镜像:/dev/binderfs/binder_logs/(由 binderfs 以 stats=global 挂载时生成),里面是同一套文件。它的可读性最终由 SELinux 决定,但在调试机上通常能用。
stats 里每个进程那一段最值得看,它直接回答“这个进程还有没有线程、还有没有缓冲”:
proc 1234
context binder
  threads: 8
  requested threads: 0+3/15        # 已请求未启动 + 已启动 / 上限
  ready threads 2                  # 当前空闲、正在等的线程数(0 表示快要排队了)
  free async space 524288          # oneway 可用空间(初始 ≈ buffer_size / 2)
  nodes: 5
  refs: 42 s 20 w 4                # 引用总数 / 强引用 / 弱引用
  buffers: 3
  pending transactions: 0          # 已排队、还没分发的事务
failed_transaction_log 每行是一条失败事务的“事故记录”:
123: call from 1000:1234 to 1000:5678 context binder node 42 handle 7 size 8192:64 ret 17/-28 l=3540依次是 debug_id、call/async/reply、来源 pid:tid、目标 pid:tid、context、node、handle、data_size:offsets_size、返回命令号/错误码、源码行号。上面这行 ret 17/-28 就是 BR_FAILED_REPLY + -ENOSPC——buffer 不够;如果是 ret 5/…,就是 BR_DEAD_REPLY,目标已死。
12.4 dumpsys 与 ANR trace:看进程卡在谁的调用里
工具链里最常用的三样:
- ANR trace:搜
BinderProxy.transactNative、waitForResponse、binder 线程的栈。主线程停在transactNative,说明它在等一个同步调用;但如果一堆 binder 线程停在同一个地方,说明线程池在等某个服务。要注意 trace 只告诉你“在等 binder”,不告诉你是哪个服务、哪个 code——要定位目标,得靠同一份 ANR 文件里其它进程的栈,或者 Perfetto 里这条事务的dest_proc和code。 dumpsys <service>:看服务内部状态。比如dumpsys activity能看到 AMS 的任务栈与启动状态,dumpsys window能看到窗口状态。Binder 层的问题经常在服务状态里留下线索。dumpsys binder_calls_stats:system_server 侧的 AIDL 热点统计,回答“哪个服务方法吃 CPU/延迟最高、谁在调、请求和回复最大多少字节”。默认是采样统计;要看最大请求/回复大小、异常数,先用adb shell cmd binder_calls_stats --enable-detailed-tracking打开详细跟踪,再dumpsys binder_calls_stats。
另外,trace 里的 binder 线程名有个坑:binder:1234_2 里第二段是十六进制序号,不是 tid。Android 12 及以前是 Binder:<pid>_<序号>(首字母大写),Android 13 起变成小写 binder:,并且 vndbinder / hwbinder 的线程名前缀不同。看 trace 时别把序号当 tid 去 kill 或查 /proc。
12.5 日志:最容易被忽略的入口
在打开 trace 之前,先看 logcat 里这几类日志,往往更快:
!!! FAILED BINDER TRANSACTION !!! (parcel size = N):libbinder 打的 native 日志,后面通常跟着 Java 异常;TransactionTooLargeException/Transaction failed on small parcel; ... running out of binder buffer space:buffer 分配失败,前者是 parcel > 200KB 的启发式,后者是小 parcel 版本;DeadObjectException:目标进程已死或 binder 对象已失效;Transaction failed because process frozen./received sync transactions while frozen, killing:冻结相关(第 8.6 节);Process seems to be sending too many oneway calls.:oneway 洪泛告警;avc: denied { call }/avc: denied { find } for service=...:SELinux 拒绝;ServiceNotFoundException/Waiting for service ...:服务未注册,或注册了但没通过权限检查。
12.6 实践顺序
遇到一个 Binder 相关的线上问题,我通常按这个顺序走:
- 先确认是不是 Binder:ANR trace / 卡顿 trace 里有没有
transactNative、waitForResponse、binder 线程栈; - 再看是哪一段:Perfetto 里看调用是“没发出去”“发出去了但目标没接”“目标接了但很慢”;
- 内核是否拒绝:
avc、BR_FAILED_REPLY、BR_DEAD_REPLY、buffer 分配失败、failed_transaction_log; - 目标侧是否健康:目标进程的线程池、锁、冻结状态;
- 最后才看业务代码:业务慢、数据大、调用次数多。
这个顺序的价值在于:Binder 问题的根因常常不在你以为是“业务”的那一层。先定位层次,再进代码。
13. 几个容易踩的坑 链接到此标题
前面按链路讲,这一节按事故现场讲。下面这些在真实项目里反复出现,往往不是技术难题,而是对语义的误判。
13.1 TransactionTooLargeException:先怀疑并发,再怀疑数据量
最常见的误判是“我传的数据没超过 1MB,凭什么报 TransactionTooLarge”。原因在第 10.1 节:限制针对的是当前分配时刻剩余的空间,不是单次 Parcel 的大小;而抛出哪种异常,还取决于 JNI 对 Parcel 大小的启发式判断(>200KB 才会是 TransactionTooLargeException)。
还有一个反直觉的变体:请求 Parcel 不大时,同样的 buffer 分配失败会变成 DeadObjectException,message 是 “Transaction failed on small parcel; remote process probably died, but this could also be caused by running out of binder buffer space”。看到“目标已死”的异常,别急着确认对端真的崩了,先看它的 binder 缓冲是不是满了。
三个具体来源:
- 一次
Bundle里塞了 Bitmap、长列表、大 JSON; dumpsys/dump()返回超大字符串(系统服务 dump 时经常踩);- 多个并发大事务同时飞,互相挤占同一块 1MB 区域。
定位时看三样东西:logcat 里的 !!! FAILED BINDER TRANSACTION !!! (parcel size = N)、Perfetto 里 binder_transaction_alloc_buf 的 data_size、debugfs 的 failed_transaction_log(ret 17/-28 就是 buffer 不够)。如果目标是系统服务,dumpsys binder_calls_stats 里还能看到它的最大请求/回复尺寸,能判断是不是某个接口本身就设计得太大。
修法从根上分两类:传大块数据改用共享内存/FD;传小数据但高频的,做批量合并,减少同时在场的事务数。
13.2 主线程同步 IPC:卡的不是那一次调用
第 1 节那个 ANR 就是典型。主线程上做同步 binder 调用,风险有两层:
- 这一次调用本身可能慢(对端排队、锁竞争、数据大);
- 更严重的是,主线程阻塞期间,它自己的消息队列也停摆了——生命周期、输入事件、绘制回调全部排队。
所以“主线程不做同步 IPC”不是风格建议,而是正确性要求。必须查的东西(包信息、设置项、权限状态)尽量在启动早期或后台线程预热、缓存;UI 线程只读缓存。
13.3 线程池耗尽:两个池子互相等
第 8.3 节讲过形态。这里补充几个真实诱因:
- 同步回调:A 调 B,B 在
onTransact里同步回调 A。A 的池子如果已经被别的调用占满,回调就没有线程接。 - 主线程阻塞导致的假死:主线程在做同步 IPC,而系统恰好需要主线程处理某个生命周期事务(它被 post 到主线程队列),两边互等。
- 服务端慢操作:某个服务的
onTransact里做文件 IO 或等锁,池子里的线程被慢慢占满,后续事务全部排队。 - 跨进程锁顺序:A 持锁调 B,B 的回调又要拿 A 的锁。Binder 保证不了锁顺序,只能靠设计避免。
排查时看 ANR trace 里 binder 线程的栈:如果一堆线程停在 waitForResponse 或 transactNative,基本可以确定是池子被同步等待占满。再补一个内核视角:debugfs stats 里如果 ready threads 0、pending transactions 大于 0、requested threads: 0+15/15,说明池子已经到顶。
服务端自己可以调的旋钮是 ProcessState::setThreadPoolMaxThreadCount()(native 侧);把上限调高能缓解排队,但线程会一直存在,调太高只是把 CPU 和内存压力换了种形式,官方文档也提醒过“加线程不等于加吞吐”。
13.4 oneway 的三个误解
- “oneway 就是后台执行”:不是。它在服务端的 binder 线程上执行,只是调用方不等。
- “oneway 不会失败”:入队阶段会失败(目标死、冻结、buffer 不够),只是失败发生在发送方 ioctl 的那次往返里,容易被忽略。成功入队之后,事务可能静默丢失。
- “oneway 可以随便发”:同一 node 串行、独立配额、不继承优先级。高频 oneway 会把接收方的 buffer 和线程压满。
还有一个容易被忽略的细节:oneway 的入队失败,AIDL 生成的 void 存根通常不看 transact() 的返回值(只写 mRemote.transact(..., FLAG_ONEWAY) 就回收 Parcel),所以错误更容易被吞掉。官方 threading 文档写得很直白:“the process containing the callee can die or freeze without processing a function call and without providing any failure”。需要可靠投递的场景,oneway 之外还得有确认机制。
13.5 死亡通知与引用泄漏
三种高发形态(第 9.4 节详述):静态持有 BinderProxy、服务端存客户端回调不清理、以为 GC 会释放内核 ref。
补充一个细节:linkToDeath 之后如果对象一直活着,DeathRecipient 不会被调用;但如果你忘了 unlinkToDeath,BinderProxy 会一直持有这个 recipient,recipient 又持有外部对象(Activity、Fragment、ViewModel),泄漏链条就这么形成了。系统服务里注册回调,务必在 onDestroy / close 里解绑。
13.6 在 binder 线程上碰 UI、做慢操作
onTransact 跑在 binder 线程上。在这里:
- 直接操作 View 会抛
CalledFromWrongThreadException(或者更糟,静默改错状态); - 做文件 IO、数据库、网络会占住池线程,拖慢所有并发调用;
- 等另一把锁可能造成死锁。
正确做法:onTransact 只做参数校验与状态更新,耗时工作 post 到主线程或工作线程;需要同步返回结果的,把锁的持有范围压到最小。
13.7 持锁发起 IPC:锁顺序反转
Binder 不理解你的锁。A 进程持有锁 L1 调 B,B 的回调又需要 A 的 L1,就会死锁。这类问题在系统代码里尤其常见,因为锁往往在很上层。
经验规则:不要在持锁状态下发起同步跨进程调用。如果必须,把数据准备好、放锁、再调用;或者用 oneway 把“通知”和“处理”解耦。
13.8 身份与权限:clearCallingIdentity 的坑
Binder.clearCallingIdentity() 的语义是“以本进程的身份继续执行”,返回一个 token,必须用 restoreCallingIdentity(token) 恢复。常见错误:
- 忘记恢复,后续操作全部以错误的身份执行(可能绕过或触发权限检查);
- 在异常路径上没有恢复(要用 try/finally);
- 以为调用它就能“变成系统身份”——它只是还原成本进程身份,不是提权。
另一个误判是把 SELinux 拒绝当成“服务不存在”。getService 返回 null 时,先看 avc: denied,再怀疑注册时机。
13.9 AIDL 版本兼容:事务码是最脆弱的协议
- 方法顺序改变 → 事务码错位 → 轻则
enforceInterface失败,重则读到错位数据; - 接口 token 改变(改包名、改接口名)→ 老客户端全部失败;
- 在接口末尾追加方法一般是安全的(老客户端不会调用新事务码,服务端返回
UNKNOWN_TRANSACTION); - 手写
Parcel与 AIDL 混用 → 字段顺序、类型必须逐字节一致,最容易在跨版本时炸。
做 SDK / 系统接口时,把 AIDL 当作线上协议对待:变更要评审、要兼容、要有版本策略。
13.10 把 Binder 当日志管道
用 oneway 往系统服务狂发日志、埋点、状态上报,是 Binder 过载的常见来源。它比想象中更容易出问题:oneway 串行、配额有限、接收方处理慢就堆积;一旦接收方是 system_server,影响面是整个系统。
高频、低价值的数据应该走别的通道:日志用 logcat/EventLog,指标用专用采集,批量数据用文件或共享内存。Binder 适合“有明确接收方、需要对象语义与权限”的调用。
14. 尾声:回到那次 ANR 链接到此标题
回到开头那个 ANR。主线程停在 transactNative 2.3 秒,最终定位到:system_server 里某个包扫描任务持有 PMS 的锁,getPackageInfo 的请求在锁上排队,主线程则在等 reply。修复方式不是优化我们那行代码,而是把版本检查挪到启动早期的一次性预热里,并把 getPackageInfo 换成缓存的 PackageInfo。
这就是 Binder 的典型性格:它的机制是清晰的,但它的表现是弥散的。一个方法调用背后,是两套栈、一个内核对象系统、若干线程池和一层安全策略。只记住“Binder 是一次拷贝的 IPC”,遇到问题就会束手无策;把链路拆开,才能判断该改哪一段。
回头看,这条链路里真正值得记住的有三样:
- 对象身份:node / ref / handle 决定了“对象”在系统里怎么被引用、怎么失效、怎么通知。理解它,才能理解死亡通知、引用泄漏、服务发现。
- 同步语义:同步事务意味着两端各出一个线程,意味着线程池、优先级继承、死锁可能。理解它,才能解释 ANR 和“为什么慢”。
- 资源边界:1MB 缓冲、oneway 配额、线程池上限、SELinux 权限。理解它,才能解释那些“看起来不该报”的异常。
Android 的 Binder 还在演进:AIDL 统一了 HAL,冻结机制改变了“进程死亡”的语义,新内核加了失败事务上报,甚至开始有 Rust 实现。但底层那条链路——代理、Parcel、ioctl、内核事务、线程唤醒、回复——从 Android 1.0 到现在没有变过。理解了它,新版本带来的只是新的观测工具和新的失败模式,而不是一套需要重新背诵的流程。
附:版本速查 链接到此标题
| 能力 / 行为 | 起始版本 | 说明 |
|---|---|---|
| Binder 协议版本 7 / 8 | 长期 | BINDER_CURRENT_PROTOCOL_VERSION:32 位 7,64 位 8 |
oneway / TF_ONE_WAY | 早期 | 异步事务;按 node 串行,独立 buffer 配额 |
/dev/hwbinder、/dev/vndbinder | Android 8(Treble) | HAL 与 vendor 进程的独立 binder 域 |
binderfs 挂载 /dev/binderfs | Android 11 | mount binder binder /dev/binderfs stats=global,动态创建节点并 symlink |
BINDER_FREEZE / 冻结通知 | Android 11(kernel 5.4 UAPI 可见) | cached app freezer 协作;同步调用返回 BR_FROZEN_REPLY |
| oneway 洪泛检测 | Android 12(用户态默认开启;内核 UAPI 更早) | BINDER_ENABLE_ONEWAY_SPAM_DETECTION / BR_ONEWAY_SPAM_SUSPECT |
BINDER_GET_EXTENDED_ERROR | 6.1(Android 14) | 取 thread->ee 扩展错误信息 |
TF_UPDATE_TXN | Android 12 起 UAPI 可见,14(6.1)实现成形 | 冻结进程的旧 oneway 可被新事务顶替 |
优先级继承竞态修复(prio_lock) | 6.1(Android 14) | 处理“改优先级期间收到嵌套事务”的窗口 |
BR_TRANSACTION_PENDING_FROZEN | 6.6(Android 15) | 区分“有 pending 同步事务的冻结” |
| 16KB page size 设备 | Android 15 | 映射大小变成 1MB − 2×16KB;没有官方结论说它改变 Binder 行为 |
线程名 binder:<pid>_<十六进制> | Android 13 | A12 及以前是 Binder:…;第二段不是 tid |
TF_CLEAR_BUF / FLAG_CLEAR_BUF | Android 11/12(kernel 5.4/5.10 UAPI 可见) | 事务结束清零 buffer;释放时多一次 memset |
| 动态 AIDL 服务(lazy HAL) | Android 11 | servicemanager + LazyServiceRegistrar 按引用计数启停 |
IBinder.addFrozenStateChangeCallback | Android 16(flag API) | 服务端感知对端冻结 |
| Rust Binder 实现 | 6.12(Android 16) | binder.impl=rust 可启用;失败事务 netlink 上报 |
参考资料 链接到此标题
- AOSP:
frameworks/native/libs/binder/ProcessState.cpp - AOSP:
frameworks/native/libs/binder/IPCThreadState.cpp - AOSP:
frameworks/native/libs/binder/BpBinder.cpp - AOSP:
frameworks/native/libs/binder/Parcel.cpp - AOSP:
frameworks/base/core/java/android/os/Binder.java - AOSP:
frameworks/base/core/java/android/os/BinderProxy.java - AOSP:
frameworks/native/cmds/servicemanager/ - AOSP:
kernel/commonbinder 驱动(drivers/android/binder.c) - AOSP:
include/uapi/linux/android/binder.h - AOSP 文档:AIDL 后端
- AOSP 文档:Binder 线程模型(Handle threads)
- AOSP 文档:Binder 与进程冻结
- AOSP 文档:Binder 优先级继承
- AOSP 文档:动态 AIDL 服务
- Android 官方:
TransactionTooLargeException - Android 官方:16 KB 页大小支持
- Perfetto 文档:Android 系统 trace(atrace)
- Perfetto:binder metric 定义
- Perfetto:
binder_tracker.cc(binder slice 的合成方式) - Linux 内核文档:Binder IPC
- Android 官方:
android.os.IBinder - Android 官方:AIDL 概览